BLOG
ローカルLLM 10モデルを日本語の業務で比較 ― 選び方と任せ方
「日本語の業務に使うなら、どのローカルLLMがいいですか」。ローカルLLMのご相談で、いちばん多い質問の一つです。
当社は、顧客のソースコードや議事録を扱うprojectAIのAI機能を、クラウドのAIに送らず、社内のGPUサーバーで動かしています。2026年7月から10月までに、GPU 1枚で動く10のモデルを、自社の業務を模した同じ問題で評価しました。
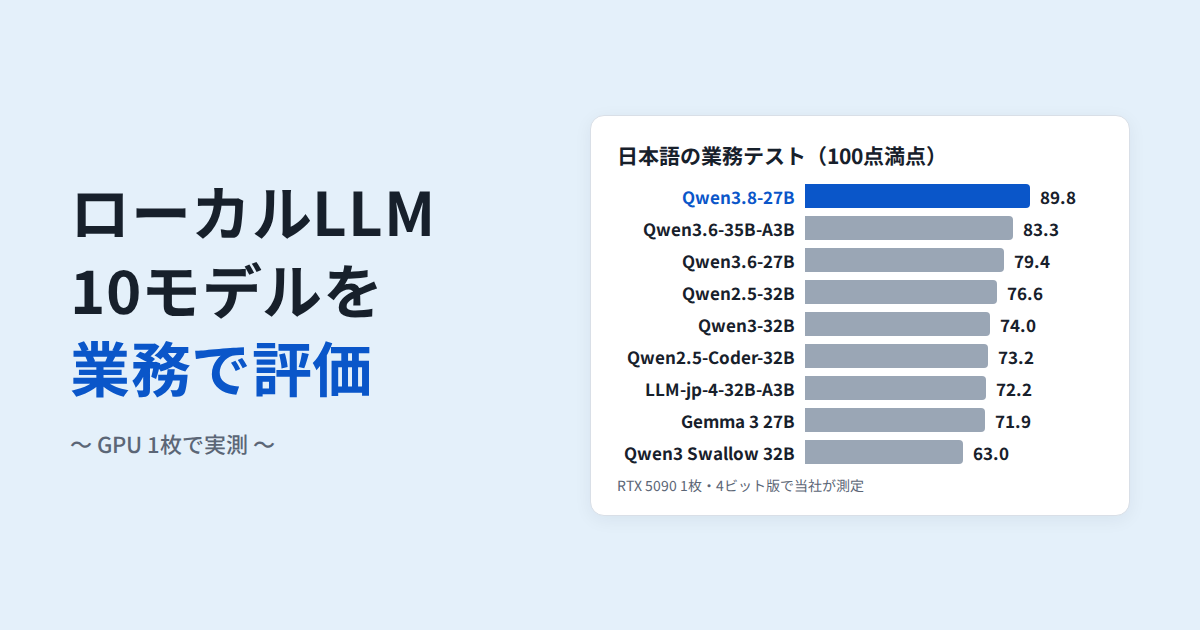
2026年10月時点の常用は、AlibabaのQwen3.8-27B(89.8点)です。ただ、点数の順に選べばよいわけではありません。日本語特化、新しさ、速さはどれも決め手にならず、どのモデルにも残る弱点は仕組みで補います。数字はすべて、当社の環境で実測したものです。

知りたいのは「解けるか」ではなく「任せられるか」
公開ベンチマークは候補を絞るのに役立ちますが、多くは英語の問題で、「解けるか」を測るものです。業務で知りたいのは、社外向けの敬語で書けるか、決められた形式(JSON)と選択肢のとおりに返すか、書かれていないことを作らないか、毎回同じように動くかです。
そこで、projectAIで実際にAIに任せている仕事から10問を作りました。敬語のメールや、指定の訳語と記号を守る翻訳、会話の分類と抽出、要約、「ちょうど3行」などの厳しい形式、乱暴な文の言い換え、間違った前提への対応、複数段階の計算です。
評価の方法
機材は、メモリ32GBのGPU(NVIDIA GeForce RTX 5090)1枚です。推論サーバーはvLLMで、モデルは4ビットに軽くした版(量子化)を使いました。Qwen2.5-Coder-32Bの8ビット版はGPUに収まらず、あふれた分をメインメモリに置いたため、約28倍遅くなりました。32GBのGPUで30B前後のモデルを動かすなら、4ビットが前提です。
- 採点:正確さ30、日本語の自然さ25、指示どおりか15、形式15、安定性10、効率5の100点満点。事実を作ったら、正確さは10点中3点までにしました
- 繰り返し:結果がぶれやすい4問は、5回ずつ解かせました
- 別の評価:システムの機能(道具)を呼び出す力を公開ベンチマークのBFCLで、エージェントの力をTerminal-Benchと自社の課題で測りました
結果:常用は、89.8点のQwen3.8-27B

10モデル目のMetaのMuse Glimmer 30B(10月に評価)は、エージェントの評価だけで比べました。合格数はQwen3.8-27Bと同じで、1問あたりの時間はコーディングで約2.2倍、汎用で約1.2倍でした(比較の記事)。1回ごとのぶれがあるため、数点の差は誤差の範囲です。
日本語特化は、日本語の業務に強いとは限らない
Qwen3 Swallow 32Bは、Qwen3-32Bに日本語を追加で学習させたモデルです。大きさも軽くし方も同じですが、点数は74.0点に対して63.0点でした。
- 会話の分類は95.2点で、評価した中でも最上位でした
- 一方、英語への翻訳では、日本語のまま訳語だけを差し替えて返しました
- 間違った前提の問題では、「伊藤博文がNTTを創業した」と、存在しない事実を答えました
国産のLLM-jp-4も、推論ありの設定では敬語の言い換えや計算が7月時点の最高でしたが、英語に訳すべき場面で日本語のまま返しました。日本語に強いことと、指示された言語と形式を守ることは、別の能力です。
新しい版でも、仕事によっては古い版に負ける
7月の時点で一番だったのは、前の世代のQwen2.5-32B(76.6点)でした。新しいQwen3-32B(74.0点)は、「本番で障害が起きた」という投稿を「依頼」と分類し、本文にない日付を期日として入れました。5回とも同じ種類の失敗です。
一方で、Qwen2.5-32Bは「日本の初代内閣総理大臣」を5回とも「吉田茂」と答えました(正しくは伊藤博文)。どちらが良いかは、任せる仕事で入れ替わります。失敗は偶然ではなくモデルの性質なので、1回試しただけで決めると見誤ります。
点数が高く速くても、決め手の仕事で劣れば替えない
Qwen3.6-35B-A3Bは83.3点で、当時の最高点でした。全体は35Bでも1回に動くのは3Bという設計(MoE)で、応答は平均0.78秒と、常用していたQwen3.6-27Bの半分以下です。
それでも切り替えませんでした。BFCLの「複数回のやり取り」が、27Bの56.0%に対して50.9%だったからです。projectAIのAIエージェント「Mr.AI」は、システムの機能を何度も呼びながら仕事を進めます。入れ替えの決め手は、全体の点数ではなく、自社でいちばん大事な仕事の評価です。比べる前に、それを決めておきます。
世代が上がって、苦手な仕事が直った
8月に公開されたQwen3.8-27Bは、Qwen3.6-27Bの後継です。同じ条件で比べると、79.4点から89.8点に上がりました。伸びたのは、苦手だった仕事です。
| 問題 | Qwen3.6-27B | Qwen3.8-27B |
|---|---|---|
| 乱暴な文の言い換え | 62 | 80 |
| 間違った前提への対応 | 58 | 90 |
| 複数段階の計算 | 42 | 88 |
BFCLの複数回のやり取りも56.0%から59.0%に上がり、速さはほぼ同じでした。当社は評価したその日に、元に戻す手順を用意したうえで常用を切り替えました。止めた時間は約3分半です。
推論モードは、万能ではない
答える前に考えを書く設定(推論モード)も、Qwen3.6-27Bで試しました。難問40問の正解は、推論なしが35問、推論ありが36問で、1問あたりの時間は約5倍(6.1秒と29.3秒)でした。推論ありでは、『吾輩は猫である』が連載された雑誌を、存在しない名前で答えました。推論なしでは正しく答えた問題です。当社は、日常の仕事を推論なしで動かしています。
残る弱点は、仕組みで補う
モデルを替えても、残りやすい弱点があります。
| 弱点 | 補い方 |
|---|---|
| 文字数をぴったり守れない | 出力をプログラムで数え、だめならやり直す |
| 知らない固有名詞を作る | 根拠の文書を渡して答えさせ、出典を確かめる |
| 日本語に他の言語が混ざる | 利用者に見せる前に出力を確かめる |
| 呼ぶべきでない機能を呼ぶ | 実行してよいかはルールで決める |
文字数が苦手なのは、モデルが文字ではなく「トークン」という単位で文章を扱うためです。
エージェントにも天井がありました。Terminal-Benchでは、Qwen3.6-27Bを当社のエージェントに載せて改良を重ねても、標準のエージェント(51.3%)に届かず46.2〜48.7%で、残った失敗の多くはモデルの能力の不足でした。Qwen3.8-27Bに替えた今は、自社の課題25問に全問合格しています。過去の開発依頼では、小さな修正はクラウドのAI(Claude)と同じ行を同じように直した一方、大きめの不具合は症状が消える最小の範囲で止まりました。
当社の任せ方(2026年10月時点)
- ローカルLLMに任せる:翻訳、要約、会話の分類、根拠つきの抽出、1回の機能の呼び出し、範囲のはっきりした小さな修正
- 確かめる仕組みと一緒に任せる:期日の抽出(本文と照合)、敬語のメール(誰が何をするかを明記)、文字数などの形式(プログラムで検証)
- 人の確認を前提にする:あまり知られていない固有名詞や法令の詳細、大きめの開発の変更
任せる範囲の考え方はAIに業務を任せるとはに、機能ごとにクラウドとローカルを切り替える運用はローカルLLM導入事例にまとめています。
この評価の限界
- 問題の数は多くなく、すべて4ビットの版です。LLM-jp-4はGPUが空いておらずCPU(llama.cpp)で動かしたため、速さは比べていません
- いずれも評価した時点の版です。LLM-jp-4は、2026年9月に後継のLLM-jp-4.1が公開されています
- 結果は当社の業務と環境でのもので、モデルそのものの優劣を示すものではありません
よくあるご質問
日本語の業務に向くローカルLLMはどれですか?
当社の評価では、2026年10月時点でQwen3.8-27Bが最も高い89.8点で、32GBのGPU 1枚で動きます。ただし向くモデルは業務で変わるため、自社の業務の問題で確かめてから選びます。
日本語に特化したモデルを選べば安心ですか?
そうとは限りません。分類や敬語に強い一方で、英語に訳すべき場面で日本語のまま返すことがありました。翻訳やシステムにつなぐ仕事では、指示された言語と形式を守るかを確かめます。
推論モードは、オンにしたほうがいいですか?
仕事によります。当社の難問40問では、正解は1問増えただけで、時間は約5倍になりました。日常の仕事はオフで動かしています。
新しいモデルが出るたびに、入れ替えたほうがいいですか?
同じ評価で常用のモデルを上回ったときだけ入れ替えます。当社は10モデルを評価し、入れ替えたのは8月の1回だけです。
自社で評価するには、何から始めればよいですか?
AIに任せたい仕事から10問ほど作り、それぞれの正しい答えを決めるところからです。ぶれやすい問題は5回繰り返し、作り話をいちばん重く減点します。
まとめ
10モデルを同じ問題で比べて分かったのは、日本語特化や新しさ、速さではなく、決め手の仕事と、指示した言語と形式を守るかで選ぶべきだということです。どのモデルにも残る弱点は、プログラムで確かめる仕組みで補えば、GPU 1枚でも多くの仕事を任せられます。
当社は、貴社の業務から評価の問題を作り、候補のモデルと機材の組み合わせを、機材を買う前に比べます(導入の流れ)。どのモデルが自社の業務に合うかを知りたい方は、無料見積相談で担当PMにご相談ください。「今のモデルを替えるべきか」という段階のご相談でも構いません。
関連する記事とページ
- ローカルLLM構築・導入支援 ― ハードウェア選定から運用まで
- ローカルLLMの必要スペックとおすすめモデル ― VRAM・GPUの目安
- Muse Glimmer 30BとQwen3.8-27Bの比較 ― 同じエージェント評価で選ぶ
- ローカルLLM導入事例 ― クラウドAIと機能ごとに使い分け
- AIエージェント導入事例 ― 変更依頼を本番まで進めるMr.AI
- AIに業務を任せるとは ― 任せる範囲と確かめ方、失敗の直し方
出典
- vLLM「vLLM」(GitHub)
- llama.cpp「llama.cpp」(GitHub)
- UC Berkeley「Berkeley Function Calling Leaderboard」(BFCL V4。bfcl-eval 2025.8.6.2で測定)
- Terminal-Bench「Terminal-Bench」(terminal-bench-core 0.1.1で測定)
- Qwen「Qwen3.8-27B」(Hugging Face、2026年8月公開)
- Qwen「Qwen3.6-35B-A3B」(Hugging Face)
- Swallow LLM「Qwen3-Swallow-32B-RL-v0.2」(Hugging Face)
- 国立情報学研究所「大規模言語モデル「LLM-jp-4.1」シリーズを公開」2026年9月28日
- Meta「Muse-Glimmer-30B」(Hugging Face、2026年8月公開)
- cyankiwi「Qwen3.8-27B-AWQ-INT4」(Hugging Face、評価に使った版)
- QuantTrio「Qwen3.6-35B-A3B-AWQ」(同)
- QuantTrio「Qwen3.6-27B-AWQ」(同)
- Qwen「Qwen2.5-32B-Instruct-AWQ」(同)
- Qwen「Qwen3-32B-AWQ」(同)
- Qwen「Qwen2.5-Coder-32B-Instruct-AWQ」(同。8ビット版はGPTQ-Int8)
- llm-jp「llm-jp-4-32b-a3b-thinking-gguf」(同。Q4_K_M)
- gaunernst「gemma-3-27b-it-qat-autoawq」(同。Googleのgemma-3-27b-itを変換した版)
- tokyotech-llm「Qwen3-Swallow-32B-RL-v0.2-AWQ-INT4」(同)
- NVIDIA「Muse-Glimmer-30B-NVFP4」(同)