
CASE STUDY
データを社外に出さないAI運用 — 機能ごとにクラウドAIサービスとローカルLLMを使い分ける、自社の実践事例
最初に
当社は、業務ツール「projectAI」のAI機能を、機能ごとに「ChatGPT や Claude のようなクラウドAIサービス」と「自社の管理環境で動かすローカルLLM」に振り分けて運用しています。この事例では、その仕組みをなぜ作り、どう作り、どう使い分け、運用して何が分かったかをまとめます。要点は3つです。
- AIの機能ごとに処理する場所を選べ、切り替えは約30秒で全体に反映される
- ローカルLLMが使えないときはクラウドAIサービスへ、クラウドAIサービスが使えないときはローカルLLMへ、自動で切り替わる
- ローカルに任せる前に、クラウドAIサービスと同じ入力で並走させ、結果を人が比べて判定する
この事例でいう「自社の管理環境」は、当社の設備と、当社が契約して管理するクラウド環境のことです。「ローカルLLM」は、その中で動かすAIを指します。第三者のAI事業者にデータを送らない、という意味で使っています。
projectAI 全体のAI機能は projectAI の全社運用事例 に、お客様の環境でローカルLLMを構築する支援は ローカルLLM構築・導入支援 のページにまとめています。
なぜ自社の管理環境でAIを動かす必要があったか
いちばん大きな理由は、費用だった
projectAI では、翻訳、チャットの仕分け、議事録の整理など、多くの機能でAIを呼び出しています。クラウドAIサービスは、呼び出すたびに従量課金がかかります。AIに任せる仕事が増えるほど、費用もそのまま増えていきます。
とくに、翻訳のように毎日大量に繰り返す処理では、この費用が大きくなります。ローカルLLMなら、機材・電気・保守の費用はかかりますが、呼び出しごとの費用はかかりません。量の多い処理をローカルへ移せば、AIを使う場面を増やしても、費用が膨らみにくくなります。
次に、機密性。AIが読むのはお客様からお預かりした情報だった
projectAI では、AIがお客様とのチャット、議事録、障害の報告、お客様からお預かりした資料、仕様、タスクを読んで仕事をします。どれも、お客様からお預かりした情報です。
法人向けのクラウドAIサービスの多くは、入力を学習に使わない契約を用意しています。クラウドAIサービスが危ないから避けたい、ということではありません。ただ、お客様との契約や社内の規程で「社外のAI事業者に送らない」と決まっている情報は、どれだけ便利でもクラウドAIサービスには渡せません。そうした情報を扱う業務では、AIを使うこと自体をあきらめるしかありませんでした。
この悩みは当社だけのものではありません。総務省の令和8年版情報通信白書では、生成AIの活用で日本企業が懸念するリスクとして、「社内情報の漏洩などのセキュリティリスク」が46.4%で最も多く挙がっています。
自分たちで運用していないものは、提案できない
もう一つの理由は、提案の責任です。お客様に「費用を抑え、データを社外に出さない構成もできます」とお伝えするなら、その構成を自分たちが毎日使い、良い点も難しい点も知っている必要があります。そこで、まず自社の業務ツールで、ローカルLLMを本番の仕事に使うことにしました。
どう作ったか — 3つの部品
仕組みは、振り分けの設定、社内の処理装置、すべての処理の記録の3つでできています。

1. 機能ごとの振り分けの設定
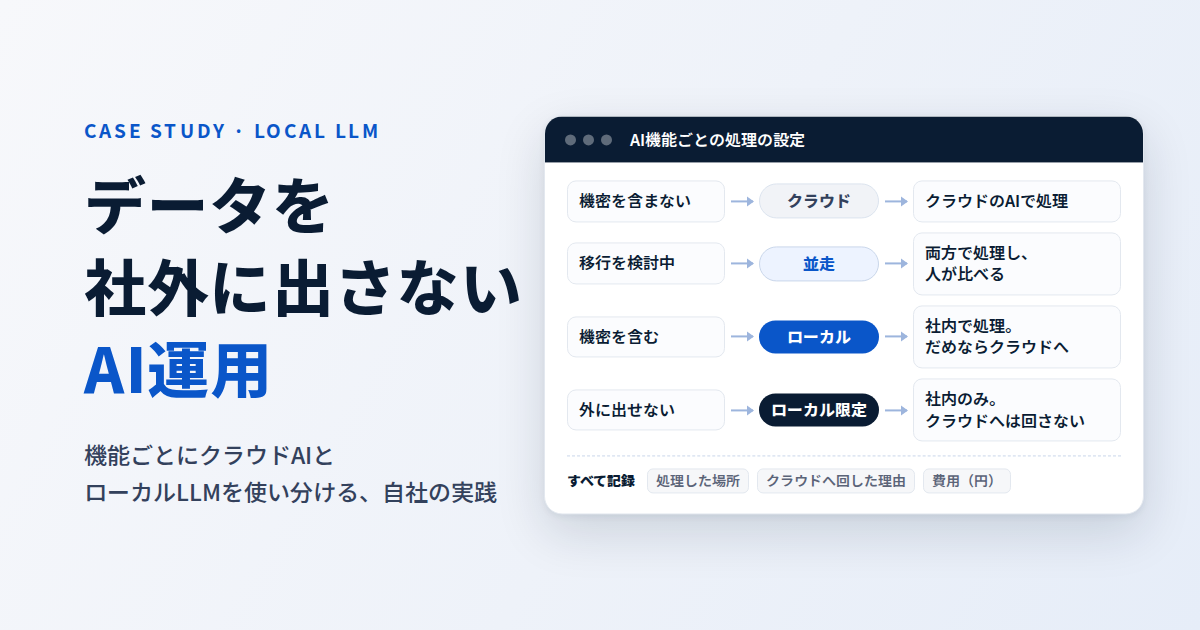
AIの機能ごとに、次の4つから処理の方法を選びます。
| 設定 | 処理する場所 | 使う場面 |
|---|---|---|
| クラウド | クラウドAIサービス | 機密を含まない処理。新しく加えた機能は、まずこの設定から始める |
| 並走 | 応答はクラウドAIサービスが返し、同じ入力をローカルでも処理して結果を比べる | ローカルへの移行を検討している機能 |
| ローカル | ローカル。使えないときはクラウドAIサービスへ切り替え、理由を記録する | 移行を決めた機能 |
| ローカル限定 | ローカルのみ。使えないときも、クラウドAIサービスへは回さない | クラウドAIサービスに渡せない情報を扱う機能 |
設定を変えられるのは管理者だけで、変更の履歴が残ります。変更は約30秒で全体に反映され、システムを止める必要はありません。全体を一度にクラウドAIサービスへ戻すスイッチもあります。
2. 外から入る口を持たない、社内の処理装置
社内の処理装置は、外から呼ばれるのを待つのではなく、自分から仕事を取りに行きます。
業務ツールは、ローカルで処理する依頼を順番待ちの列に置くだけです。社内の処理装置が外向きに接続して列から依頼を受け取り、処理して、結果を書き戻します。外から処理装置に入ってくる入口は作っていません。
処理装置は定期的に「動いている」という知らせを送ります。知らせが途切れたり、処理が時間内に終わらなかったりしたときは、自動でクラウドAIサービスに切り替えます。逆に、クラウドAIサービスが障害で使えないときは、自動でローカルLLMに切り替えられるようにしています。ローカル限定の機能だけは、クラウドAIサービスへは回さずに止めます。
3. すべての処理の記録
AIを呼び出すたびに、どこで処理したか、切り替えたかどうかとその理由、費用、どの案件の処理かを記録します。管理画面では、直近に切り替えが起きた件数を確認できます。
費用は機能ごとに円で表示します。ローカルで処理した分は、呼び出しごとの従量課金がかからないため0円として記録します。ただし、機材・電気・保守の費用は別にかかります。この固定の費用は、記録とは分けて考えています。
機能ごとに、クラウドAIサービスとローカルLLMを使い分ける考え方
判断の軸は4つ
- AIに渡す情報の機密度。外に出せない情報を扱う機能は、費用に関係なくローカルへ移します。AIが読む情報を3段階に分け、機密度の高いものから移す方針にしています。
- 呼び出す量と費用。毎日大量に呼び出す機能ほど、ローカルへ移したときに費用が下がります。機能ごとの従量課金が円で見えるため、どこから移すかを数字で決められます。
- 入力の大きさと、出力の長さ。長い文書をまとめて読む処理や、長い文章を書く処理は、ローカルでは時間がかかります。こうした機能は、移す順番を後にしています。
- 品質の確かめやすさと、間違えたときの影響。最初に移したのは翻訳です。呼び出す量が多く、原文と見比べれば品質を確かめやすく、間違えても直しやすいからです。
| 機密度 | AIが読む情報の例 | 方針 |
|---|---|---|
| 最も高い | お客様とのチャット、議事録、障害の報告、お預かりした資料 | 優先してローカルへ移す |
| 高い | 仕様、タスク | 品質を確かめながら順に移す |
| 低い | 作業の記録に付く補助的な情報 | クラウドAIサービスのままでもよい |
使えないときにクラウドAIサービスへ切り替えてよい機能は「ローカル」、切り替えてはいけない機能は「ローカル限定」にします。
いま、どう使い分けているか
- ローカルで処理している: 翻訳、文中のタスクの参照を実際のタスクに結び付ける処理
- 並走で比べてきた: 議事録から決定事項を抜き出す処理
- 用途で分けている: AIエージェント「Mr.AI」がプログラムを直す仕事のうち、プログラムを社外に出せない案件の小さな不具合の修正は、ローカルで行う選択肢を用意しています。比較では、小さな修正ではクラウドAIサービスと同じ結果に届いた一方、複数の機能にまたがる修正ではテストを省く傾向が見られたため、機能の追加はクラウドAIサービスに残しています
ローカルLLMはクラウドAIサービスの代わりではなく、互いの予備です。どちらかが使えなくなっても、自動で切り替わって業務が続きます。
並走で確かめてから、任せる
ローカルに任せるかどうかは、並走の結果で決めます。同じ入力をクラウドAIサービスとローカルの両方で処理し、2つの出力を組にして保存します(7日で自動的に削除します)。管理画面で2つを並べ、人が「ローカルで可」「同等」「劣る」を判定し、機能ごとに集計します。ローカルが答えを出せなかった分は別に数え、失敗が集計に埋もれないようにしています。
前述の白書では、生成AIの導入後に定期的な評価・検証を行っている日本企業は29.1%でした。ローカルLLMに限らず、AIの品質は「入れたあとに測る仕組み」がないと分かりません。並走は、その仕組みを日々の運用に組み込んだものです。
運用して分かった良い点と、難しい点
良い点
- 量の多い処理の費用が下がる。翻訳のように毎日繰り返す処理をローカルへ移したことで、その分の従量課金がかからなくなりました。
- 一度に全部を移さなくてよい。機能単位で、止めずに、約30秒で切り替えられるため、確かめながら少しずつ移せます。うまくいかなければ、同じ手間で戻せます。
- どちらかが止まっても、業務が止まらない。ローカルLLMとクラウドAIサービスが自動で切り替わるため、片方の障害で業務が止まりにくくなりました。
- 記録があるから、問題に気づける。切り替えが起きた件数と理由が残るため、「ローカルで処理しているつもりだった」という思い込みを記録で確かめられます。
難しい点
- 長い処理は、待ち時間の設計が難しい。長い文書の翻訳が、待ち時間の上限を超えることがありました。さらに、ローカルの待ちが上限を超えるとクラウドAIサービスへ切り替わるため、両方で処理されて費用が二重にかかる場面もありました。機能ごとに待ち時間と一度に渡す量を見直しています。
- 気づかないうちに、クラウドAIサービスで処理されていた。一度に渡す一覧が量の上限を超え、ローカルではなくクラウドAIサービスで処理され続けていたことがあります。記録に残っていたので気づけましたが、記録を見る習慣がなければ見過ごしていたはずです。
- 新しい機能は、振り分けの外に漏れやすい。機能を増やしていくと、振り分けの仕組みを通らない処理が紛れ込むことがありました。新しい機能を加えるたびに、振り分けの対象に入っているかを確かめています。
- 社内向けの情報が、表に出ないようにする。どちらで処理したかという社内向けの情報が、お客様の画面に表示されていたことがあり、社内の画面だけに表示するよう直しました。
- 機材を持つと、運用も自分たちの仕事になる。処理装置の停止、更新、見守りは当社の仕事です。止まったときに自動で切り替える仕組みがあるから、続けられています。
これから導入する会社への示唆
- 全部をローカルにしなくてよい。AIに渡す情報を機密度で、呼び出しを量と費用で棚卸しし、効果の大きい機能から移します。
- 移す前に、並走で比べる。判定するのは人です。判定の結果をもとに、任せてよい機能から切り替えます。
- 使えないときの切り替え方を、先に決める。クラウドAIサービスへ切り替えてよいのか、止めて人に回すのか。機能ごとに決めておきます。
- 処理した場所と理由を、すべて記録する。記録がなければ、費用が本当に下がったのか、データが本当に社内で処理されているのかを確かめられません。
- 機材の運用を誰が担うかを決める。停止や更新のときにどう動くかまで決めて、はじめて業務に使えます。
当社の ローカルLLM構築・導入支援 では、この進め方を貴社の業務と情報の扱いに合わせて設計します。最初は一つの機能から始められます。
よくあるご質問
ローカルLLMにすると、クラウドAIサービスより精度は下がりますか。 機能によって異なります。決まった形で出力する処理や、入力の短い処理は任せられた一方で、長い文書や、複数の機能にまたがる判断はクラウドAIサービスに残しています。だからこそ、並走で確かめてから切り替えています。
データは一切、社外に出ないのですか。 「ローカル限定」にした機能の処理は、第三者のAI事業者に送りません。「ローカル」にした機能は、ローカルで処理できないときにクラウドAIサービスへ切り替わることがあり、その場合は理由とともに記録します。どちらにするかは、機能ごとに決めます。
ローカルLLMなら費用はかかりませんか。 呼び出しごとの従量課金はかかりませんが、機材・電気・保守の費用がかかります。呼び出す量が多い機能ほど、移したときの効果が大きくなります。費用の考え方は ローカルLLM構築・導入支援 のページにまとめています。
ChatGPT や Claude などのクラウドAIサービスは使わないほうがよいのですか。 いいえ。当社もクラウドAIサービスを使い続けています。機密を含まない処理や、長い文書を扱う処理はクラウドAIサービスのほうが向いている場面も多く、ローカルLLMとは互いの予備にもなります。大切なのは、機能ごとに使い分けることです。
小さな会社や、一つの部署からでも始められますか。 はい。呼び出す量の多い機能や、機密度の高い一つの機能から、並走で確かめながら始めるのが基本です。
関連する事例とサービス
- ローカルLLM構築・導入支援 — 機密データを社外に出さずに生成AIを使う
- AIエージェント「Mr.AI」の社内運用事例 — 変更依頼を、仕様から本番反映まで進める
- 自社開発ツール「cockpit」の開発事例 — 複数の案件とAIエージェントを、1つの画面とスマホで動かす
- projectAI の全社運用事例 — 45のAI機能と、データ・費用の扱い
- AIエージェント・生成AIの導入事例8件 — 業務に組み込んだAIの事例を分野別に一覧
- AI導入支援
出典: 総務省「令和8年版 情報通信白書 懸念されるリスク及びリスク対策のための取組状況」図表Ⅰ-2-1-8「生成AIの活用に関して懸念されるリスク(国別)」、図表Ⅰ-2-1-9「リスク対策のための取組状況(国別、企業規模別(日本))」
FREE ESTIMATE
見積もりは無料。最初の通話で、開発の内容と費用感がわかります
要件が固まっていなくても構いません。作りたいものを一言いただければ、担当のPMが一緒に整理します。