BLOG
ローカルLLMエージェントは、ハーネスでどこまで良くなるか
「ローカルLLMでも、AIエージェントは作れますか」。ローカルLLMのご相談で、最近よくいただく質問です。
作れます。当社は、GPU 1枚(RTX 5090)で動くモデルを使ったAIエージェントを自社で開発し、2026年7月から10月までに十数回、同じ課題で評価しては直してきました。今は、自社の開発依頼のうち、小さく範囲のはっきりした修正を任せています。
モデルの比較はローカルLLM 10モデルを日本語の業務で比較に書きました。この記事は、モデルの周りの仕組み(ハーネス)の話です。ハーネスで速さは10倍になりましたが、賢さの天井はモデルで決まりました。数字はすべて、当社の環境で実測したものです。

ハーネスとは
AIエージェントは、AIが自分で手順を考え、コマンドを実行したりファイルを直したりしながら仕事を進める仕組みです。モデルは考える部分で、その周りで道具を渡し、指示を組み立て、選んだ行動を実行し、結果を戻し、止めどきを決める仕組みをハーネスと呼びます。
当社のハーネスは、1回に1つの行動をとり、ふだんはすばやく動く役(推論なし)が進めます。失敗が続いたときだけ、じっくり考える役(推論あり)を呼びます。どちらも同じモデルです。ハーネスを自社で作ったのは、自社の業務の道具、規約、権限、記録に合わせるためです。
評価のしかた
ハーネスを直すたびに、前の版と同じ課題で比べました。
- 自社の課題:汎用12判定(ファイル操作、計算、曖昧な依頼への質問など)と、コーディング最大13問。テストの合否や作ったファイルで、プログラムが採点します。手数、トークン数、時間も記録しました
- 公開ベンチマーク:Terminal-Bench。同じモデルを、Terminal-Benchの開発チームが比較用に作った標準のハーネス(Terminus-2、道具は端末1つだけ)と当社のハーネスに載せて比べました
- 実際の開発依頼:過去の依頼を同じ開始地点から解かせ、クラウドのAI(Claude)の変更と比べました
変わったこと:速さは10倍になった
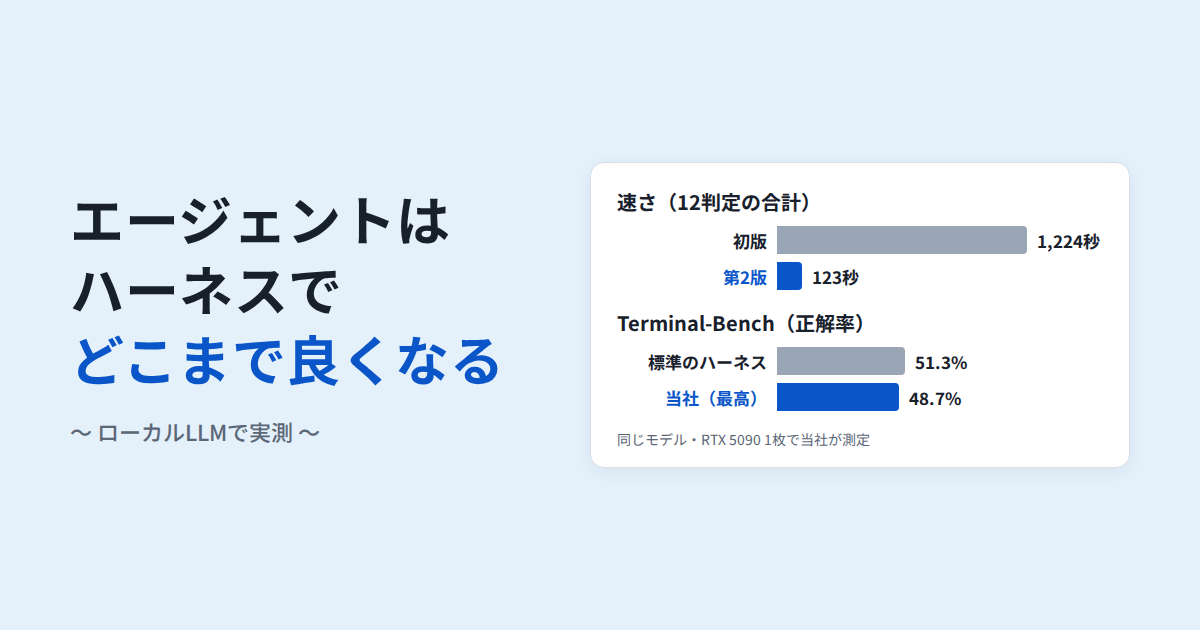
初版は、毎回、動く前に計画を立て、終わったあとに必ず確認する作りでした。汎用の12判定で合計1,224秒かかり、曖昧な依頼では、質問すべきところを計画役が勝手に内容を決めて進めました。
第2版では、ふだんはすばやい役だけで進め、「2回続けて失敗した」などのときだけ考える役を呼ぶ形にしました。12判定すべてに合格し、合計123秒でした。

小さな引っかかりを消すだけでも効きました。エージェントが素の「python」を打っては失敗していたので、使うべきPythonが最初から見つかるようにすると、コーディング8問は133秒から83秒になりました。
変わらなかったこと:公開ベンチマークの点数
Terminal-Bench(terminal-bench-core 0.1.1の80課題のうち78課題)では、同じQwen3.6-27Bで、標準のハーネスが51.3%、当社は改良を重ねても46.2〜48.7%でした。最初の走行は、長いコマンドの時間切れ、一時的な通信エラー、作業記録がモデルの読める量を超えたことで、序盤の11課題で1つしか解けませんでした。どれも仕組みの不具合で、直してから比べています。

当社が勝ったのは、探索、データの処理、コードの修正です。1手ごとに結果を見て次を決める進め方が効きました。標準のハーネスが勝ったのは、長い手順を正しい順番で打ち込む課題です。
落とした42課題を1つずつ読むと、手数を使い切ったのは6課題だけでした。28課題は、エージェントが「完了」と報告したのに間違っていました。
- 自分で整形した出力を自分で確かめて「正しい」とした。採点が見ていたのは、整形する前の形だった
- 正常な入力だけを試し、端の値や不正な入力を試さなかった
確かめてはいたものの、確かめる相手が課題の基準ではなく、自分の思い込みでした。
原因ごとに対策を入れた版は48.7%で、新しく7課題を解いた一方、5課題を落としました。状態を保ったまま対話できるシェルも作りましたが、点数は上がらず、既定ではオフにしています。最後の版で落とした課題でいちばん多かったのは、足した対策そのものがうまく働かなかったもの(14課題)です。版どうしの差は、1回ごとのぶれ(3〜4課題)に収まりました。このモデルでは、ハーネスだけで60%を超えるのは難しいと判断しました。
足した仕組みが、新しい失敗を生んだ
作業記録を1つずつ読むと、仕組みの側の失敗が見つかりました。
- 長い出力を途中で省くと、モデルは省かれた部分をもっともらしく埋めた。「3.22.4」を「v32.4」と書くなど。省いたことを明示し、読み直させて防いだ
- 確認役のAIが「こんにちは」の逆順を「わちにんこ」と誤り、正しい答えを差し戻した。確認役も同じモデルなので、同じように間違える
- ファイルを書く行動で書き込む先が抜け、「それはフォルダです」という誤解を招くエラーを返したため、同じ行動を10回繰り返した。何が届いて何が足りないかを具体的に返して解決した
- 1回の出力の上限を16,384トークンに広げたら、同じ断片を繰り返す出力が上限まで続き、241秒を無駄にした。繰り返しを検知して打ち切り、上限は8,192にとどめた
- 機能を足した改修の不具合で、ファイルを直す道具がファイルを空にした。エージェントは控えから戻して完走したため合否では分からず、手数が倍の108手になったことで気づいた
実際の開発依頼では、小さな修正を任せられる
| 依頼 | 当社のエージェント | Claude |
|---|---|---|
| 見出しの文言を変える | 同じ行を同じように修正、206秒 | 32秒 |
| 設定画面に注意書きを足す | 変更したファイルが一致、336秒 | 123秒 |
| 保存できない不具合を直す | 画面の層だけ修正、555秒 | 原因の層とテストも、162秒 |
小さな修正はClaudeとほぼ同じ変更を出し、大きめの修正は症状が消える最小の範囲で止まりました。時間は約3〜6倍です。直すべき層やテストを依頼に書いておくと補えます。実際の依頼1件は、テスト2本を含む4ファイルを変更し、既存のテスト1,971件を通してプルリクエストまで進めました。常駐のサービスとして動かすと開発の道具(pnpm)が見つからずに止まったこともあり、評価は本番と同じ動かし方で行う必要があります。
天井を上げたのは、モデルの交換
8月に、ハーネスはそのままで、モデルをQwen3.6-27BからQwen3.8-27Bに替えました。汎用の課題では、出力トークンが約4割になり、1課題の時間はおよそ半分から4分の1になりました。10月に試したMuse Glimmer 30Bは、合格数は同じで、1問あたりの時間がコーディングで約2.2倍、汎用で約1.2倍でした(比較の記事)。Terminal-Benchの論文も、性能を上げるにはハーネスよりモデルの選択が重要なことが多い、と結論づけています。
だから当社は、ハーネスをモデルを替えやすい作りにしておき、新しいモデルが出るたびに同じ課題で測り直します。
エージェントを評価するときのこつ
- 課題は自社の仕事から作り、プログラムで採点する。合否を人の印象で決めない
- 合否だけでなく、手数、トークン、時間を記録する。壊れていても完走することがある
- 公開ベンチマークは、同じ版を何回か走らせる。ぶれが改良の差より大きいことがある
- 足す前に、失敗を1つずつ読む。思い込んだ原因(手数不足)と、本当の原因(間違ったまま完了)は違った
この評価の限界
- 自社の課題は数が少なく、Terminal-Benchも各版1回の走行です。数課題の差は、ぶれの範囲です
- Terminal-Benchは、今の版ではなく、初期の課題セット(terminal-bench-core 0.1.1)で測りました
- 開発依頼の比較は数件で、Claudeの時間は依頼の処理全体の時間です
- 結果は、当社のハーネスと環境(RTX 5090 1枚、4ビットに軽くしたモデル)でのものです
よくあるご質問
ローカルLLMで、AIエージェントは作れますか?
作れます。当社は32GBのGPU 1枚で動くQwen3.8-27Bで、自社の課題(コーディング13問、汎用12判定)に全問合格するエージェントを動かし、小さな開発の修正を任せています。
ハーネスは、既製のものと自社開発のどちらがいいですか?
公開ベンチマークでは、標準のハーネスが当社のものを上回りました。まず既製のハーネスで測り、自社の道具、規約、権限、記録で足りない点が分かってから作るのが近道です。
ハーネスを工夫すれば、クラウドのAI並みになりますか?
なりません。ハーネスで変わるのは主に速さ、安定、失敗したときの振る舞いで、賢さの天井はモデルで決まります。
開発の作業を、ローカルのエージェントに任せられますか?
小さく範囲のはっきりした修正なら任せられます。大きな修正は、直すべき層とテストを依頼に書き、人のレビューを前提にします。
エージェントの評価は、何から始めればいいですか?
任せたい仕事を10個ほど書き出し、合格の条件をプログラムで確かめられる形で決めるところからです。
まとめ
ハーネスで、エージェントの速さは10倍になりました。一方で、公開ベンチマークの点数は改良を重ねても上がらず、天井を上げたのはモデルの交換でした。ハーネスは速さと安定のために作り、賢さはモデルで選びます。
当社は、貴社の業務に合わせたAIエージェントの設計から、評価の課題づくり、モデルと機材の選定、運用までを担当します(AI導入支援)。社外にデータを出さずにAIに仕事を任せたい方は、無料見積相談で担当PMにご相談ください。「どこまで任せられるか試したい」という段階のご相談でも構いません。
関連する記事とページ
- ローカルLLM構築・導入支援 ― ハードウェア選定から運用まで
- ローカルLLM 10モデルを日本語の業務で比較 ― 選び方と任せ方
- Muse Glimmer 30BとQwen3.8-27Bの比較 ― 同じエージェント評価で選ぶ
- AIエージェント導入事例 ― 変更依頼を本番まで進めるMr.AI
- AIに業務を任せるとは ― 任せる範囲と確かめ方、失敗の直し方
出典
- Terminal-Bench「Terminal-Bench」(terminal-bench-core 0.1.1で測定)
- Merrill ほか「Terminal-Bench: Benchmarking Agents on Hard, Realistic Tasks in Command Line Interfaces」(arXiv)2026年1月17日
- vLLM「vLLM」(GitHub)
- Qwen「Qwen3.8-27B」(Hugging Face、2026年8月公開)
- Meta「Muse-Glimmer-30B」(Hugging Face、2026年8月公開)