
BLOG
ローカルLLMのモデルは、機材で決まる ― 環境とモデルを一緒に選び、見積もる
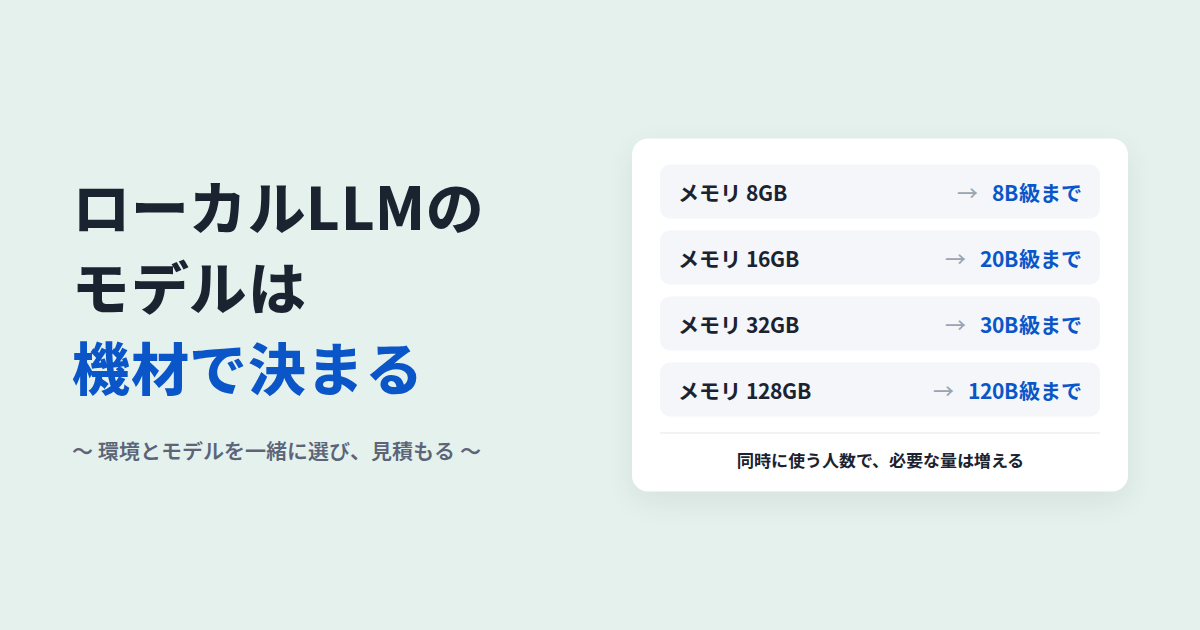
「ローカルLLMには、どのモデルを使えばいいですか」。ローカルLLMのご相談で、よくいただく質問です。
答えは、使う機材で変わります。同じ開発元のモデルでも、大きさは数十倍から数百倍違います。大きいモデルほど答えの質は上がりやすく、そのぶん多くのメモリを使います。
この記事では、機材のメモリで動かせるモデルが決まる仕組みと、機材ごとの候補を説明します。そのうえで、環境とモデルを一緒に選び、見積もる進め方を紹介します。
内容は、2026年10月14日に各社の公式ページとモデルの説明書きで確認したものです。
モデルを先に決めると、機材が合わない
モデルには、大きさの違う版があります。たとえばAlibabaのQwen3.5は、0.8B(8億パラメータ)から397B(3,970億パラメータ)まで、8つの大きさで公開されています[1]。
モデルの大きさは、必要なメモリの量に直結します。GoogleのGemma 4では、4ビットに軽くした場合でも、最小のE2Bは2.9GB、最大の31Bは17.5GBのメモリを使います[2]。
そのため、評判のいいモデルから先に決めると、次のどちらかになりがちです。
- 機材に収まらず、動かない。または遅くて使えない
- 必要以上に大きな機材を買ってしまう
モデルと機材は、どちらかを先に決めるものではありません。業務に必要な答えの質と、使い方から、組み合わせで決めます。
必要なメモリは、4つの要素で決まる
ローカルLLMを動かすには、モデルの本体と、会話の作業用のデータが、GPUのメモリ(VRAM)に収まる必要があります。必要な量は、次の4つで決まります。
1. モデルの大きさ
モデルの大きさは、パラメータ数で表します。「27B」なら270億です。軽くしない場合(16ビット)、パラメータ数(B)の約2倍のGBが要ります[3]。27Bのモデルなら、約54GBです。
2. 軽くする度合い(量子化)
数値の桁を減らしてモデルを軽くすることを、量子化と呼びます。よく使われる4ビットの形式では、パラメータ数(B)の約0.6倍のGBに収まります。たとえば8Bのモデルは、約4.9GBになります[4]。
ただし、軽くするほど、答えの質は下がりやすくなります。ある研究では、量子化による日本語の性能の低下が、自動の評価では1.7%でも、人の評価では16.0%でした[5]。日本語で使うなら、軽くしすぎないことも選択肢です。
3. 一度に読ませる文章の長さ
モデルは、会話や読ませた文書を、作業用のメモリ(KVキャッシュ)に置きながら答えます。読ませる文章が長いほど、この量が増えます。長い文書を読ませると、モデルの本体の半分ほどの量になる例もあります[3]。
4. 同時に使う人数
作業用のメモリは、同時に使う人数ぶん要ります。1人で試すときは足りていた機材でも、部署の10人が同時に使うと足りなくなることがあります。
作業用のメモリの量は、モデルの設計によっても大きく違います。そのため、同時に使う人数と、読ませる文章の長さを決めてから、モデルごとに計算します。

答えの速さは、メモリの速さで決まる
メモリの量が足りても、答えが遅ければ業務では使えません。LLMが文章をつくる速さは、主にメモリからデータを読み出す速さ(帯域)で決まります[6]。
同じくらいの量のメモリを持つ機材でも、帯域は数倍違います。たとえばNVIDIAの机に置ける小型のAI専用機は毎秒273GB、業務用のGPUは毎秒1,792GBです[7][8]。メモリの量だけで機材を選ぶと、動くけれど遅い、ということが起きます。
機材ごとに、動かせるモデルの目安
2026年10月時点で、機材のメモリごとに動かせるモデルの例をまとめました。4ビットに軽くし、1人で使う場合の目安です。
| メモリの量 | 機材の例 | 動かせるモデルの例 | 向いている使い方 |
|---|---|---|---|
| 8GB前後 | 入門向けのGPUを積んだPC、メモリ16GBのMac | Gemma 4 E4B、Qwen3.5-4B、LLM-jp-4.1-8b | 個人での試用。短い文の要約や下書き |
| 16GB | 中級のGPUを積んだPC、メモリ24GBのMac | gpt-oss-20b、Gemma 4 12B、Qwen3.5-9B | 少人数での検証。社内文書の検索を試す |
| 24〜32GB | 一般向けの上位GPU、メモリ36〜48GBのMac | Qwen3.8-27B、Gemma 4 31B、Muse Glimmer 30B、LLM-jp-4.1-33b | 部署での検証。日本語の質を求める業務 |
| 80〜128GB | 業務用のGPU、メモリ128GBのMacや小型のAI専用機 | gpt-oss-120b、Mistral Small 4、Qwen3.5-122B-A10B | 部署での本番。30B前後のモデルを、軽くしすぎずに使う |
| 数百GB以上 | データセンター向けのGPUを複数積んだサーバー | DeepSeek V4、Qwen3.5-397B-A17B | 全社での同時利用。大きなモデルを使う |
30B前後のモデルは、24GBの機材では、長い文書を読ませる余裕が少なくなります。
MacやAI専用機の一部は、CPUとGPUでメモリを共有します。この場合、積んだメモリの大部分をモデルに使えます。表のMacのメモリが多めなのは、すべてをモデルには使えないためです。
GPUがないPCでも、CPUだけで小さなモデルは動きます。ただ、答えが返るまでに時間がかかり、業務で毎日使うには向きません。
置き場所も、選び方に入る
機材をどこに置くかで、費用と始め方が変わります。
- パソコン:手軽に試せる。多くの人で使うには向かない
- 社内のサーバー(オンプレミス):社内の規程で、自社の設備での保管が必要な場合に向く。機材の調達に時間がかかる
- 自社専用のクラウド環境(閉域クラウド):機材を買わずに始められる。使う量に応じて費用がかかる
閉域クラウドのGPUで先に試し、使えると分かってから機材を買うこともできます。
機材が決まったら、モデルを絞る
同じ機材に収まるモデルの中から、ライセンス、開発元、日本語の3つで絞ります。
ライセンス:商用で使えるか
この記事で挙げたモデルの多くは、Apache 2.0かMITで公開されており、条件を守れば商用で使えます。一方で、公開されていても条件が付くモデルがあります。
| モデル | 主な条件 |
|---|---|
| Llama 4(Meta) | 月の利用者が7億人を超える会社は、Metaの許諾が要る。「Built with Llama」の表示が要る[9] |
| PLaMoの公開モデル(Preferred Networks) | 社内だけで使う場合も商用の扱い。事前の登録が要る。直近の年間の売上が10億円を超える会社(関係会社を含む)は、別の商用ライセンスが要る[10] |
| Mistral Medium 3.5、Devstral 2 | 月の売上が2,000万ドルを超える会社は使えない[11] |
| EXAONE 4.x(LG) | 商用では使えない[12] |
Swallowのように、海外のモデルに日本語を追加で学習させたモデルは、土台のモデルのライセンスも引き継ぎます。使う前に、その時点の文面を自社の法務部門と確認してください。この記事は法的な助言ではありません。
開発元:社内の規程に合うか
Qwen、DeepSeekなど、中国の開発元のモデルは、性能が高く種類も多くあります。
自社の機材で動かす場合、入力したデータが開発元に送られることはありません。一方で、モデルの答え方の癖は残ります。米国の国立標準技術研究所(NIST)の評価では、DeepSeekのモデルが、特定の話題で偏った説明を返しやすいことなどが報告されています[13]。
社内の規程や取引先の要件で開発元の国が問われる場合は、Gemma 4(Google)、gpt-oss(OpenAI)、Muse Glimmer(Meta)、Mistralのモデル、国産のLLM-jp-4.1などから選べます。
日本語:業務の言葉で正しく答えるか
東京科学大学のSwallow LLMリーダーボードでは、公開モデルの最上位はGemma 4 31Bでした。日本語の平均点は0.675で、クラウドAIのGPT-5(0.685)に近い水準です[14]。W&BのNejumi LLMリーダーボード4でも、1台の機材で動く大きさのモデルのうち、Qwen3.8-27BとGemma 4 31Bが上位に並びます[15]。
国産のLLM-jp-4.1は、総合的な点数では海外の最新モデルを下回ります。一方で、土台のLLM-jp-4は日本で一から学習されており、学習に使ったデータも公開されています[16][17]。中身を説明しやすいモデルです。
主なモデルの一覧
| モデル | 開発元 | 主なサイズ | ライセンス |
|---|---|---|---|
| Qwen3.8 | Alibaba(中国) | 27B | Apache 2.0 |
| Qwen3.5 / 3.6 | Alibaba(中国) | 0.8B〜397B-A17B | Apache 2.0 |
| Gemma 4 | Google(米国) | E2B〜31B | Apache 2.0 |
| gpt-oss | OpenAI(米国) | 20b、120b | Apache 2.0 |
| Muse Glimmer | Meta(米国) | 30B | Apache 2.0 |
| Mistral Small 4 / Ministral 3 | Mistral AI(フランス) | 3B〜119B | Apache 2.0 |
| LLM-jp-4.1 | 国立情報学研究所(日本) | 8B、32B-A3B、33B | Apache 2.0 |
| ELYZA-Thinking-1.0(llm-jp-4) | ELYZA(日本) | 32B-A3B、33B | Apache 2.0 |
| GPT-OSS Swallow / Qwen3 Swallow | 東京科学大学・産総研(日本) | 8B〜120B | Apache 2.0 |
| DeepSeek V4 | DeepSeek(中国) | 284B〜 | MIT |
「35B-A3B」のような表記は、全体が35Bで、1回の処理で動くのは3Bという意味です(MoEという仕組み)。動く部分が小さいので速く答えられますが、メモリには全体を載せる必要があります。各モデルの出典は、参考文献の[18]〜[25]です。
機材を買う前に、自社の質問で比べる
評価表は、候補を絞るのに役立ちます。ただ、自社の業務で使えるかどうかは、自社の質問で試して初めて分かります。
- 業務を1つ決める:社内規程の検索、議事録の要約など
- 質問を20〜50問用意する:実際の質問と、正しい答え、根拠の文書をそろえる
- 組み合わせを2〜3つ用意する:候補のモデルと機材を、同じ条件で動かす
- 人が採点する:正しさ、根拠、日本語の自然さ、答えるまでの時間を見る
閉域クラウドのGPUを使えば、機材を買う前に、組み合わせごとの質と速さを確かめられます。
モデルだけでは、社内の文書を知りません。社内の文書を探す仕組み(RAG)と組み合わせて比べます。仕組みの全体は、ローカルLLMとは?で説明しています。
環境とモデルは、一緒に見積もる
費用を動かすもの
ローカルLLMの費用は、モデルと環境の組み合わせで大きく変わります。当社がお見積もりするときは、次のことで費用が決まります。
- 使うモデル(大きさ・数)
- 環境(機材・置き場所)
- 使う人数と、同時に使う人数
- 読ませる文書の量と長さ
- 既存のシステムとの連携
- 運用の担い手
当社のローカルLLMの導入費用は、基本的に数百万円から数十億円です。幅が大きいのは、組み合わせによって、必要な機材が桁違いに変わるためです。
見積もりの前に、整理しておくと早いこと
すべて決まっていなくても構いません。次のことが分かっていると、組み合わせを早く絞れます。
- AIに任せたい業務と、扱うデータ(社外に出せるか)
- 使う人数と、同時に使う人数の見込み
- 読ませたい文書の種類と量
- 社内の規程で、置き場所や開発元に条件があるか
- 始めたい時期
モデルは、数か月ごとに入れ替わる
公開モデルの更新は速く、Qwenは2026年の2月、4月、8月と、半年で3回、新しい版を出しました[1]。
そのため、機材は今のモデルだけでなく、入れ替える先のモデルも見込んで選びます。仕組みをモデルに依存しない形でつくっておけば、新しいモデルに入れ替えて、同じ質問で比べ直せます。
よくあるご質問
ローカルLLMに必要なVRAMはどのくらいですか?
モデルの大きさと、軽くする度合いで決まります。4ビットに軽くした場合、パラメータ数(B)の約0.6倍のGBが目安です。27Bのモデルなら約17GBです。これに、読ませる文章の長さと、同時に使う人数に応じたメモリが加わります。
VRAM 16GBで動くおすすめのモデルはどれですか?
gpt-oss-20b、Gemma 4 12B、Qwen3.5-9Bなどが動きます。長い文書を読ませる場合は、作業用のメモリが増えるため、余裕を持たせます。
ローカルLLMのおすすめのモデルはどれですか?
機材によって変わります。2026年10月時点では、24〜32GBのメモリがあれば、Qwen3.8-27BやGemma 4 31Bが有力です。16GBなら、gpt-oss-20bやGemma 4 12Bが候補です。どれも商用利用ができます。
日本語に強いモデルはどれですか?
国内の評価表では、1台の機材で動く大きさのモデルのうち、Gemma 4 31BとQwen3.8-27Bが上位です。国産では、LLM-jp-4.1とその派生モデルがあります。自社の業務の言葉で試して確かめます。
GPUがなくてもローカルLLMは動きますか?
小さなモデルなら、CPUだけでも動きます。ただ、答えが返るまでに時間がかかります。CPUとGPUでメモリを共有するMacなどでは、GPUを別に積まなくても、比較的大きなモデルを動かせます。
社内の多くの人が同時に使うには、どのくらいの機材が要りますか?
モデルの本体に加えて、同時に使う人数と、読ませる文章の長さに応じたメモリが要ります。作業用のメモリの量はモデルの設計でも変わるため、人数と使い方を決めてから計算します。多くの人が使う場合は、vLLMなど、同時の利用に強いソフトで動かします[26]。
機材を買う前に試せますか?
試せます。閉域クラウドのGPUを使えば、機材を買わずに、モデルと機材の組み合わせごとの答えの質と速さを確かめられます。
ローカルLLMの導入費用はいくらですか?
当社では、基本的に数百万円から数十億円です。使うモデル、環境(機材・置き場所)、使う人数、連携の範囲によって大きく変わります。見積もりは無料です。
まとめ
ローカルLLMで使えるモデルは、機材のメモリで決まります。必要なメモリは、モデルの大きさ、軽くする度合い、読ませる文章の長さ、同時に使う人数の4つで変わります。
だから、モデルと環境は、どちらかを先に決めるのではなく、業務と使い方から組み合わせで選び、一緒に見積もります。
当社は、業務の仕分けから、モデルと機材の構成、費用の見通しまでを、最初の1〜2週間で整理します(導入の流れ)。機材を買う前に、閉域クラウドで組み合わせを比べることもできます。自社の業務ツールでも、AI機能ごとにクラウドとローカルを切り替えて動かしています(社内の実践事例)。
環境とモデルの組み合わせと、費用感を知りたい方は、無料の見積もり相談からご連絡ください。決まっていないことが多い段階でも構いません。サービスの内容は、ローカルLLM構築・導入支援をご覧ください。
参考文献
- Qwen「Qwen3.8(GitHub)」
- Google「Gemma models overview」
- Hugging Face「Optimizing LLMs for Speed and Memory」
- llama.cpp「quantize README」
- K. Marchisio ほか「How Does Quantization Affect Multilingual LLMs?」Findings of EMNLP 2024
- NVIDIA「Mastering LLM Techniques: Inference Optimization」
- NVIDIA「DGX Spark」
- NVIDIA「RTX PRO 6000 Blackwell Workstation Edition」
- Meta「Llama 4 Community License Agreement」
- Preferred Networks「PLaMoコミュニティライセンス」
- Mistral AI「Mistral Medium 3.5 LICENSE」、「Devstral-2-123B-Instruct-2512」
- LG AI Research「EXAONE-4.5-33B」
- NIST「CAISI Evaluation of DeepSeek AI Models Finds Shortcomings and Risks」2025年9月
- Swallow LLM「Swallow LLM Leaderboard v2」
- Weights & Biases Japan「Nejumi LLM リーダーボード4」(2026年10月14日確認)
- 国立情報学研究所 大規模言語モデル研究開発センター「LLM-jp-4.1」
- LLM-jp「llm-jp-corpus v4.1」
- Qwen「Qwen3.8-27B」
- Google「Gemma 4」、「Gemma 4 license」
- OpenAI「Introducing gpt-oss」
- Meta「Muse-Glimmer-30B」
- Mistral AI「Mistral Small 4」、「Introducing Mistral 3」
- ELYZA「ELYZA-Thinking-1.0-llm-jp-4-33b」
- Swallow LLM「GPT-OSS Swallow」、「Qwen3 Swallow」
- DeepSeek「DeepSeek V4 Preview Release」、「DeepSeek-V4-Flash」
- vLLM「vLLM(GitHub)」