LOCAL LLM
ローカルLLM構築・
導入支援
ローカルLLMとはChatGPTのような生成AIを、外部のサービスに頼らず、自社の中で動かす仕組みです。入力したデータは社外に出ません。
自社の管理環境
ChatGPTのような
AI事業者が提供
運用・セキュリティ
人間
- 確認と承認
- 定着
UI人がAIを使う画面のこと。チャットや業務アプリの画面などです。(画面)
- チャット
- 業務アプリ
- 既存システム
エージェント業務ごとの役割を持ち、決めた手順や道具を使って仕事を進めるAIのこと。
- 任せる仕事と手順
- 使える道具と権限
ハーネスモデルを制御する仕組み。社内文書の検索、道具の接続、出力の確認などを担います。
- 社内文書の検索(RAG質問に関係する社内文書を探し、その内容をもとにAIに答えさせる仕組み。)
- ツール接続(MCPAIを社内システムや道具につなぐための共通の決まり(接続方式)。)
- ガードレールAIへの入力や出力を確かめ、誤りや不適切な内容を止める仕組み。
モデル文章を理解し、つくるAIの本体。大規模言語モデル(LLM)とも呼びます。
- オープンモデル中身が公開されていて、自社の機材で動かせるAIのモデル。利用条件はモデルごとに違います。
- 量子化モデルを軽くして、少ないメモリで動かす技術。答えの質が少し下がることがあります。
- 独自学習自社のデータを使って、モデルに追加で学習させること。(必要なら)
環境(機材)
- GPUサーバーAIの計算を速く行う部品(GPU)を積んだサーバー。
- 閉域クラウドインターネットから切り離して使う、自社専用のクラウド環境。
- 推論エンジンモデルを動かして答えを出すソフト。設定しだいで、さばける量が変わります。
電力
- 消費電力の見積もり
- 電源と冷却
- 省電力の設定
データ
- 社内文書
- データベース
- 業務システム
機材とモデルの選定から、エージェント、画面、社内への定着まで、すべての層をまとめて担当します。当社は自社でも、複数の環境でLLMを動かしています。
WHY LOCAL
ローカルLLMを検討するきっかけ
「社内規程で、クラウドAIが使えない」
「取引先との契約で、外部への送信が禁止されている」
「業務のネットワークが、インターネットにつながっていない」
「すべてローカルにして、費用が見合うか不安」
COMPARE
ローカルLLMとは:クラウドの生成AIとの違い
違いは、入力したデータが社外に出るかどうかです。
クラウドの生成AI
データは社外のAI事業者へ
- 良い点最新のモデルを使える
- 良い点すぐに始められる
- 注意点機密データは入力できないことがある
ローカルLLM
データは自社の中だけ
- 良い点機密データも扱える
- 良い点使う量が増えても、費用が増えにくい
- 注意点高度な推論は、クラウドに劣ることがある
- 注意点環境の準備と運用が必要
一般的な傾向です。貴社の業務での差は、並走検証で確かめます。
HOW TO CHOOSE
ローカルLLMの導入形態:業務ごとに選ぶ3つの使い方
会社で1つに決める必要はありません。業務ごとに選びます。
クラウド中心
機密を含まない業務向け。ローカルは無理に勧めません。
併用
機密を含む処理だけを、社内で動かします。
完全ローカル(閉域)
外部には一切送信しない構成です。
ローカルLLMをおすすめしない場合
- 機密を扱わず、クラウドAIで社内の規程を満たせる
- 何よりも最高水準の答えの質が必要
- 使う量が少なく、費用が見合わない
3つの質問で、合う形を確かめる
回答 0 / 3
LAYERS
ローカルLLMの7つの層と、当社の支援
図と同じ順に並べています。記載のない層は、当社が構築します。開くと、詳しい内容と根拠が見られます。
人間確かめる人と、使い続ける仕組み
定着を支援人が確認する場面とAIに任せる場面を決め、研修と手順書で定着させます。
- 確認と承認の設計
- 研修と引き継ぎ
研究からAIが得意な作業では速さが25.1%上がり、苦手な作業では正答率が84.5%から60〜71%に下がりました。[1]
UI(画面)根拠を確かめられる画面にする
業務システムやアプリの中で使え、答えの根拠をその場で確かめて直せる画面にします。
- 業務システムへの組み込み
- 根拠の表示
研究から出典を付けると、中身が無関係な出典でも信頼が上がることが分かっています。[2]
エージェント業務ごとに、任せる範囲を決める
決まった手順で進めるワークフロー決めた手順どおりに、AIと道具を動かす仕組み。か、AIが手順を選ぶ形かを、業務のリスクで選びます。
- 任せる仕事と手順の設計
- 使える道具と権限の設定
研究から最先端のモデルでも、同じ作業を8回くり返して毎回成功した割合は25%未満でした。[3]
ハーネスモデルを、何層もの確認で制御する
オープンモデル中身が公開されていて、自社の機材で動かせるAIのモデル。利用条件はモデルごとに違います。は、そのままでは文章を返すだけです。RAG質問に関係する社内文書を探し、その内容をもとにAIに答えさせる仕組み。、MCPAIを社内システムや道具につなぐための共通の決まり(接続方式)。によるツール接続、ガードレールAIへの入力や出力を確かめ、誤りや不適切な内容を止める仕組み。で出力を制御します。
- 出力形式の固定と検証
- 入力と道具の確認
研究から同じモデルのまま、道具の設計を変えただけで、課題の解決率が11%から18%に上がりました。[4]
当社の実績ローカルLLMで動く社内のエージェントに、読み取り専用の道具、使える場所の制限、操作の記録を組み込んで運用しています。
モデルオープンモデル中身が公開されていて、自社の機材で動かせるAIのモデル。利用条件はモデルごとに違います。を、貴社のデータで比べて選ぶ
ランキングではなく、貴社の業務の問いで比べて選びます。
- 日本語の質と利用条件の確認
- 量子化モデルを軽くして、少ないメモリで動かす技術。答えの質が少し下がることがあります。したときの質の確認
研究から量子化モデルを軽くして、少ないメモリで動かす技術。答えの質が少し下がることがあります。による日本語の質の低下は、自動評価では1.7%でも、人の評価では16.0%でした。[5]
データ独自学習自社のデータを使って、モデルに追加で学習させること。の前に、RAG質問に関係する社内文書を探し、その内容をもとにAIに答えさせる仕組み。から
当社が接続まずRAG質問に関係する社内文書を探し、その内容をもとにAIに答えさせる仕組み。で足りるかを確かめ、必要な場合だけ追加学習(LoRA少ない計算と機材で、モデルに追加学習させる方法。など)を行います。
- 社内文書・データベースの接続
- 閲覧権限の反映
研究から社内の知識を答えさせる比較では、追加学習よりRAG質問に関係する社内文書を探し、その内容をもとにAIに答えさせる仕組み。のほうが一貫して正確でした。[6]
環境(機材)メーカーに縛られない機材と、推論エンジンモデルを動かして答えを出すソフト。設定しだいで、さばける量が変わります。の選定
機材を販売していないので、メーカーに縛られずに選べます。自社でも複数の環境でLLMを動かしています。
- 買う前に、閉域クラウドインターネットから切り離して使う、自社専用のクラウド環境。のGPUAIの計算を速く行うための部品。で試す
- 推論エンジンモデルを動かして答えを出すソフト。設定しだいで、さばける量が変わります。の設定
- 小さく試す数人が交代で使うGPUAIの計算を速く行うための部品。搭載のワークステーション
- 部署で使う数十人・社内文書の検索GPUサーバーAIの計算を速く行う部品(GPU)を積んだサーバー。1台、または閉域クラウドインターネットから切り離して使う、自社専用のクラウド環境。
- 全社で使う数百人・応答速度の目標あり複数のGPUサーバーAIの計算を速く行う部品(GPU)を積んだサーバー。、または拡張できる閉域クラウドインターネットから切り離して使う、自社専用のクラウド環境。
研究から同じ機材でも、推論エンジンモデルを動かして答えを出すソフト。設定しだいで、さばける量が変わります。の仕組みで、処理できる量が2〜4倍変わったという報告があります。[7]
電力消費電力と冷却を、機材より先に見積もる
要件を提案運用・セキュリティ評価・監視・記録・権限を、すべての層に
モデルや設定は、並走同じ入力をクラウドとローカルの両方に渡して、結果を比べること。で比べてから切り替えます。ISMS情報セキュリティを管理する仕組みの国際規格(ISO/IEC 27001)の認証。認証を取得した体制で扱います。
- 利用者の権限
- 操作の記録
- 社外送信の記録
- データの流れの図
研究から同じ名前のクラウドのモデルでも、3か月で、ある作業の正答率が84%から51%に変わった例があります。[9]
貴社と当社の役割
| 項目 | 貴社にお願いすること | 当社が担うこと |
|---|---|---|
| 業務とデータ | 優先順位と、AIに渡してよい範囲の判断 | 棚卸しと仕分けの案 |
| 答えの質 | 業務で使えるかの判定 | 判定の問いづくりと集計 |
| 環境と電力 | 置き場所の決定と社内の承認 | 機材・電力の要件、設計と構築 |
| 運用 | 社内の窓口 | 監視・更新・引き継ぎ |
OUR PRACTICE
当社の実例:機能ごとにクラウドとローカルLLMを使い分ける
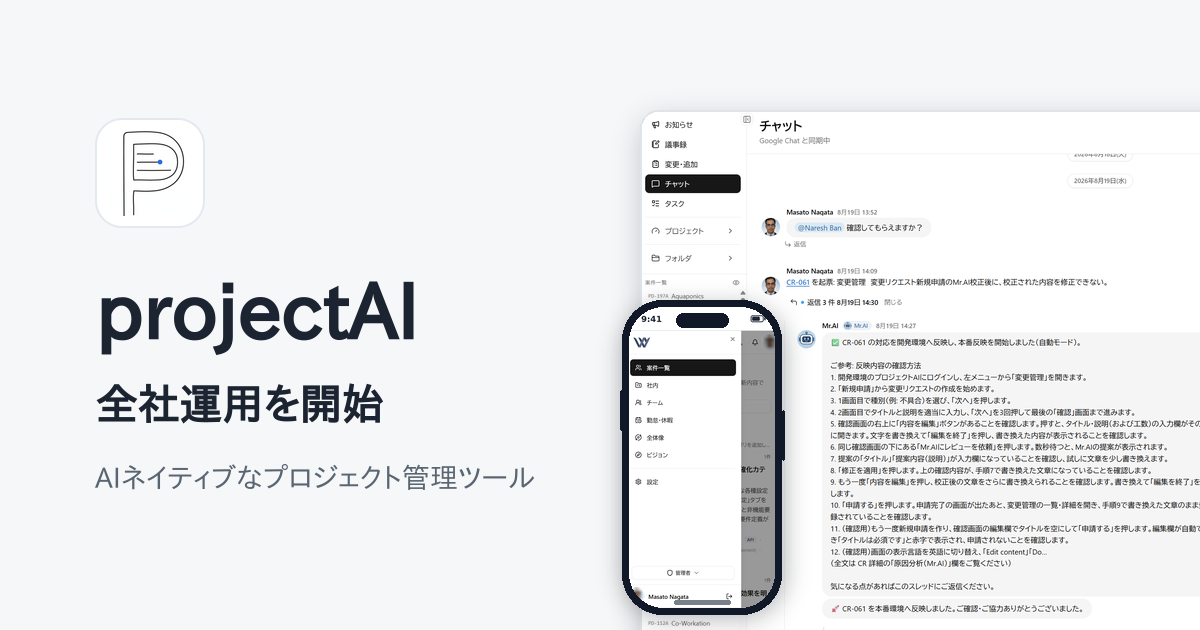
自社の業務ツール「projectAI」で、AIの機能ごとに処理する場所を切り替えています。ご提案するのは、この毎日動いている仕組みです。
- 機密を含まない処理クラウドのみクラウドのAIで処理
- 移行を検討中の処理並走両方で処理して、結果を比べる
- 機密を含む処理ローカル優先ローカルで処理。できないときだけクラウドへ回し、理由を記録
ローカルに任せるまでの4段階
- クラウドで動かす
- ローカルを並走させる
- 結果を人が比べる
- 任せてよい機能から切り替える
運用していること
- 切り替えは機能ごと。約30秒で反映され、システムは止めません
- クラウドへ回した処理は、理由とともにすべて記録
- AIの費用を、機能別・案件別に円で記録
FLOW
ローカルLLM導入の流れ
業務を仕分け、構成を決める
社外に出せるデータと出せないデータを分け、業務ごとの使い方、モデルと機材の構成、費用の見通しを決めます。
ここでやめても、仕分け表と構成案は残ります
並走させて比べる
同じ入力をクラウドとローカルに渡し、答えの質・速さ・費用を比べます。機材を買う前に、クラウドのGPU環境で試せます。
判定に使った問いは、後のモデル更新にも使えます
本番の環境をつくる
環境とエージェント機能(社内文書の検索、道具、検証、権限、記録)を整えます。機材を買う場合は、調達期間が別にかかります。
社内審査に使えるデータの流れの図もお渡しします
運用し、社内に引き継ぐ
監視とモデル更新を担います。手順書を整え、社内で運用できるまで引き継ぎます。
当社が運用を続けることもできます
COST & DURATION
ローカルLLMの導入費用と期間の考え方
ローカルLLMの費用は、基本的に数百万円から数十億円です。使用するモデルと環境によって、費用が大きく変わります。
費用を動かすもの
使用するモデルと環境で、大きく変わります
- 使用するモデル(大きさ・数)
- 環境(機材・置き場所)
- 使う人数・同時に使う人数
- 扱う文書の量
- 既存システムとの連携
- 運用の担い手
閉域クラウドなら、機材を買わずに始められる場合もあります。
期間の目安
検証まで、約1か月半から
- 仕分け:1〜2週間
- 並走での検証:約1か月〜
- 本番の環境づくり:1〜3か月程度
- 運用と引き継ぎ:継続
機材を買う場合は、調達期間が別にかかります。
FAQ
ローカルLLMの導入でよくあるご質問
ローカルLLMとは何ですか?
生成AIを、自社の設備や自社が管理するクラウドの中で動かす使い方です。入力した情報が、社外のAI事業者に送られません。
クラウドAIのAPIを使う場合と、何が違いますか?
ChatGPTのようなクラウドAIでは、API外部のサービスの機能を、プログラムから呼び出すための窓口。クラウドAIはAPI経由で使います。より下の層(エージェント業務ごとの役割を持ち、決めた手順や道具を使って仕事を進めるAIのこと。の仕組みから機材・電力まで)をAI事業者が持ち、データはそこで処理されます。ローカルLLMでは、すべての層を自社の管理環境に置きます。
ローカルLLMで何ができますか?
社内文書や規程の検索、問い合わせへの回答の下書き、議事録の要約、文書の分類などです。決まった形の処理ほど向いています。
ローカルLLMなら、情報漏洩の心配はなくなりますか?
社外のAI事業者に渡る心配はなくなります。ただし社内の権限や操作の記録は別に設計が必要で、当社はそこまで構築に含めます。
ローカルLLMの答えの質は、クラウドの生成AIと比べてどうですか?
要約や検索などの決まった形の処理は、十分な水準になることが多いです。高度な推論では劣ることがあるため、並走同じ入力をクラウドとローカルの両方に渡して、結果を比べること。検証で差を確かめてから決めます。
ハードウェアの選定から相談できますか?
できます。必要な機材は、モデルの大きさ、同時に使う人数、読ませる文書の長さで決まります。閉域クラウドインターネットから切り離して使う、自社専用のクラウド環境。なら機材を買わずに始められ、買う前に試すこともできます。
自社のデータで、モデルを学習させられますか?
できます。まず社内文書の検索(RAG質問に関係する社内文書を探し、その内容をもとにAIに答えさせる仕組み。)で足りるかを確かめ、足りない場合に追加学習(LoRA少ない計算と機材で、モデルに追加学習させる方法。など)を行います。
どのモデルを使いますか?
オープンソースのモデルから、日本語の質、機材に載る大きさ、利用条件(商用利用の可否)、道具を使う力で選びます。貴社の業務で比べてから決めます。
オープンソースのモデルを、そのまま使えませんか?
文章を返すだけなら使えます。業務で使うには、社内データの検索、道具の呼び出し、出力の検証などの仕組みが要ります。当社はその設計と実装まで担当します。
オンプレミスと閉域クラウドは、どう選びますか?
契約や規程で自社設備での保管が必要ならオンプレミス自社の建物や設備に機材を置いて使うこと。、早く小さく始めたいなら閉域クラウドインターネットから切り離して使う、自社専用のクラウド環境。が向いています。
ローカルLLMの導入費用はどう決まりますか?
基本的に数百万円から数十億円で、使用するモデルと環境(機材・置き場所)によって大きく変わります。使う人数や連携の範囲も整理したうえでお見積もりします。相談は無料です。
社内文書を検索して答えさせること(RAG)はできますか?
できます。根拠の文書を示して答え、文書ごとの閲覧権限も反映します。
運用や内製化まで任せられますか?
監視とモデルの更新を担います。手順書を整え、社内で運用できるまで引き継ぐこともできます。
最終更新日:
出典(9件)
- [1]F. Dell'Acqua ほか「Navigating the Jagged Technological Frontier」Organization Science 2026
- [2]Y. Ding ほか「Citations and Trust in LLM Generated Responses」AAAI 2025
- [3]S. Yao ほか「τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains」ICLR 2025
- [4]J. Yang ほか「SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering」NeurIPS 2024
- [5]K. Marchisio ほか「How Does Quantization Affect Multilingual LLMs?」Findings of EMNLP 2024
- [6]O. Ovadia ほか「Fine-Tuning or Retrieval? Comparing Knowledge Injection in LLMs」EMNLP 2024
- [7]W. Kwon ほか「Efficient Memory Management for Large Language Model Serving with PagedAttention」SOSP 2023
- [8]J. Fernandez ほか「Energy Considerations of Large Language Model Inference and Efficiency Optimizations」ACL 2025
- [9]L. Chen ほか「How Is ChatGPT's Behavior Changing Over Time?」Harvard Data Science Review 2024