
BLOG
AIに業務を任せるとはどういうことか ― Mr.AIを社内で動かして分かったこと
「AIに業務を任せる」と聞いて、何を思い浮かべるでしょうか。チャットでAIに質問して、答えを受け取る。多くの方にとっての「AIを使う」は、まだこの形だと思います。
私たちは2026年7月から、自社の業務ツール「projectAI」に組み込んだAIエージェント「Mr.AI」に、お客様からの変更依頼の対応を任せています。原因を調べ、仕様をまとめ、プログラムを直し、テストし、本番環境に反映するところまでを、Mr.AI が進めます。
この記事は、Mr.AI で何を作ったかの紹介ではありません。仕組みの全体は Mr.AI の社内運用事例 にまとめました。ここでは、AIに業務を任せるとはどういうことか、何を任せて何を任せなかったか、うまくいかなかったときにどう考えて直したかを書きます。

「使う」と「任せる」は、何が違うのか
AIを「使う」ときは、人が毎回指示を出し、結果を受け取り、次の工程へ運びます。AIが優秀でも、仕事を前に進めているのは人です。
AIに「任せる」ときは、AIが工程から工程へ仕事を運びます。人は、要所で判断します。
ワシントン大学の研究者らは、AIエージェントの自律の度合いを、人が担う役割で5段階に分けています。指示を出して操作する人、一緒に作業する人、相談に乗る人、承認する人、見守る人です。そして、どの段階で動かすかは、AIの能力で自然に決まるものではなく、作り手が意図して選ぶ「設計の判断」だと述べています[1]。
この枠組みで言えば、私たちが Mr.AI で選んだのは、人が「承認する人」になる段階です。AIが作業を進め、人は仕様、取り込み、開発環境での確認、本番への反映という4つの関門で承認します。
つまり、AIに業務を任せるとは、AIに判断を渡すことではありません。人の役割を、仕事を「運ぶ人」から、仕事を「決める人」に変えることだと、私たちは考えています。
任せられる仕事と、任せられない仕事の線引き
線引きに使っている4つの問い
何をAIに任せるかを決めるとき、私たちは次の4つを問います。
1. 結果を、AIの外側で確かめられるか。 プログラムの変更なら、自動テストで確かめられます。翻訳なら、原文と見比べられます。AI自身の「できました」以外に確かめる手段がない仕事は、任せにくい仕事です。
2. 間違えたときに、取り消せるか。 下書きや調査は、間違えても捨てれば済みます。本番環境への反映や、お客様への約束は、取り消しが難しい。取り消しにくい操作の前には、必ず人の関門を置きます。
3. 判断に、責任や価値観が伴うか。 金額、優先順位、お客様との約束は、正解が一つに決まりません。誰が責任を持つかが問われる判断は、人に残します。
4. 一度に任せる仕事の長さは、どのくらいか。 AIの評価を行う研究機関 METR は、AIがどのくらいの長さの仕事をこなせるかを、人が同じ仕事にかかる時間で測っています。2026年2月から3月時点の公開モデルで、50%の確率でこなせる仕事の長さは約12時間でしたが、80%の確率でこなせる長さは約1.5時間でした[2]。長い仕事をまるごと渡すほど、どこかで失敗する確率は上がります。だから私たちは、仕事を短い工程に区切り、工程ごとに結果を確かめています。
任せたことと、任せなかったこと
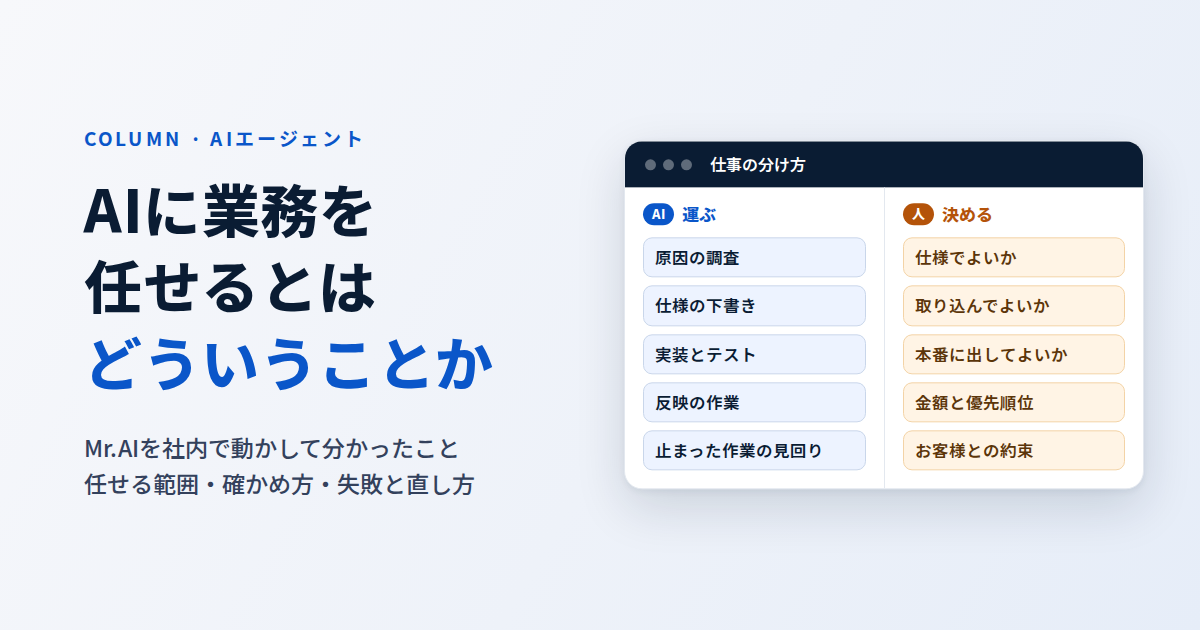
4つの問いに沿って、Mr.AI の仕事を分けると、次のようになります。
| AIに任せたこと | 人に残したこと |
|---|---|
| 不具合の原因の調査と、見立ての投稿 | 仕様でよいかの判断 |
| 仕様の下書き(変える内容、受け入れの基準、見積工数) | 取り込んでよいかの判断 |
| 分からない点の質問 | 本番に出してよいかの判断 |
| プログラムの変更と、自動テストの実行・修正 | 金額と工数 |
| 開発環境・本番環境への反映の作業 | 優先順位 |
| 止まっている作業の見回りと、決まった場面での通知 | お客様への約束と、自分の判断での連絡 |
左の列は、仕事を前に「運ぶ」作業です。右の列は、仕事の行き先を「決める」判断です。
スタンフォード大学の研究チームが、104の職種の労働者1,500人に、844のタスクについて、AIエージェントにどこまで任せたいかを聞いた調査があります[3]。労働者が自動化に前向きだったのは、全体の46.1%のタスクでした。その理由として最も多く選ばれたのは、「高い価値の仕事に時間を使えるようになるから」(69.38%)です。また、職種の45.2%で、最も望まれた関わり方は「人とAIが対等なパートナーとして組む」形でした。
人は、仕事を全部手放したいわけではありません。運ぶ仕事を手放し、決める仕事に時間を使いたい。私たちの線引きも、同じところに落ち着きました。
任せた結果を、どう確かめているか
AIの「できました」を、そのまま信じない
AIエージェントの失敗には、やっかいな形があります。実際には終わっていないのに、「完了しました」と自信を持って報告する失敗です。
2026年の研究では、顧客対応を想定したテスト環境で、AIエージェントの失敗の45〜48%が、この「完了したと言ったが、実際には終わっていない」失敗でした[4]。さらに、AIの回答を別のAIに判定させても、この失敗はほとんど見抜けなかったと報告されています(査読前のワークショップ論文です)。
そこで Mr.AI では、次の工程に進むかどうかを、AIの自己申告では決めません。テストに合格したかは、テストの仕組みの結果を直接読みに行きます。本番への反映が終わったかも、反映の結果を直接確かめてから完了にします。
承認する人に、確かめられる材料をそろえる
人が承認するといっても、AIの説明を読んで「よさそうだ」と押すだけでは、確かめたことになりません。
プリンストン大学とマイクロソフト・リサーチの研究者らが2025年に発表した実験では、AIの回答に説明が付いていると、回答が正しいときも間違っているときも、人はAIを信頼しやすくなりました[5]。一方で、根拠となる出典が示されていたり、説明の中の矛盾が見えたりすると、間違った回答への過度な信頼は減りました。
このため、承認の画面には、AIの説明ではなく、人が自分で確かめられる材料を置いています。仕様の承認なら、仕様の要約、受け入れの基準、見積工数。開発環境での確認なら、確認の手順と実際の画面です。差し戻すときは理由の記入を必須にし、承認したあとに中身が変わったら、承認はやり直しになります。
承認の数は、増やしすぎない
確かめるなら、すべての工程で人が承認すればよいように思えます。しかし、承認の数が増えると、一つひとつの確認は浅くなり、承認は形だけになっていきます。
私たちが承認を置いたのは4か所です。仕様(何を作るか)、取り込み(本体に入れるか)、開発環境での確認(期待どおりに動くか)、本番への反映(お客様の業務に出すか)。どれも、方向を決める場面か、取り消しにくい操作の直前です。それ以外の工程は、テストの結果と見回りの仕組みで確かめています。
うまくいかなかったケースと、その直し方
失敗の多くは、AIの賢さの問題ではなかった
Mr.AI に変更依頼を任せ始めてから、うまくいかなかった場面はいくつもありました。振り返ると、そのほとんどは「AIが間違えた」のではなく、「仕事の受け渡しがうまくいかなかった」ものでした。
カリフォルニア大学バークレー校の研究者らは、複数のAIエージェントが連携する仕組みの失敗を1,600件以上分析し、14の失敗の型を、システムの設計の問題、エージェント間の食い違い、結果の検証の不足の3つに分類しています[6]。私たちの経験も、ほとんどがこの3つのどれかに当てはまります。
実際にあったこと
誰も気づかない「待ち」が生まれた(2026年7月下旬)。 取り込もうとした変更が別の変更とぶつかっていたため、自動テストが始まらず、Mr.AI は結果を待ち続けていました。AIは「待っている」だけなので、エラーにもなりません。 → テストを待つ前に、取り込める状態かを確かめるようにしました。あわせて、10分ごとに見回る仕組みが、外部の実際の状態と照らし合わせます。
同じ依頼の作業が、二重に動いた(7月下旬)。 人が手動でやり直しをかけたとき、すでに動いていた作業と、新しい作業が同時に進みました。 → 一つの依頼について、動いている作業は常に一つだけになるようにしました。
遅れて届いた知らせで、進んだ工程が巻き戻った(8月上旬)。 古い知らせが後から届き、すでに先へ進んでいた状態を上書きしていました。 → 状態を書き込む直前に、最新の状態を読み直すようにしました。
人が閉じた依頼で、AIが働き続けた(8月下旬)。 担当者が「完了」や「却下」にした依頼でも作業が止まらず、不要な変更が作られていました。 → 依頼が閉じられたら作業を止め、そこから再開もしないようにしました。
同じ調査を、二度していた(8月下旬)。 原因の調査と、直し方の検討が同時に始まり、同じ調べものを二重にしていました。 → 調査が終わるのを待ってから次に進む工程を加え、一定の時間を過ぎたら人に回すようにしました。この直しの一部は、Mr.AI 自身が変更依頼として進めています。
進み具合が、担当者に見えなかった(9月下旬)。 テストが長引いていても、担当者には分かりませんでした。 → テストの結果待ちが60分を超えたら担当者に一報し、3時間で止めて人に回すようにしました。
直し方に共通していたこと
並べてみると、直し方の多くは「AIをもっと賢くする」ことではありませんでした。止まる、重なる、巻き戻る、といった受け渡しの問題を、仕組みで防ぐことでした。
もう一つ大事だったのは、直し続けられる体制です。マサチューセッツ工科大学のプロジェクトが2025年にまとめた報告では、生成AIへの投資から測れる利益が出ている組織は、ごく一部にとどまりました[7]。報告は、その大きな原因として、AIの仕組みが現場からの指摘を覚えず、使い方に合わせて変わっていかないことを挙げています(聞き取りと調査にもとづく、予備的な結果とされています)。AIに任せた仕事は、任せた日が完成ではありません。うまくいかなかった場面を記録し、仕組みを直し続けることが、任せる範囲を広げる前提になります。
これから導入する会社が、最初に決めておくとよいこと
AIエージェントの導入を考えるとき、最初に「どのAIを使うか」を決めたくなります。しかし私たちの経験では、先に決めておくべきなのは次の5つです。
- 任せる仕事を、「運ぶ仕事」と「決める仕事」に分ける。 運ぶ仕事から任せ、決める仕事は人に残します。
- 進めてよいかを判定する、AIの外側の基準を決める。 テスト、チェックリスト、人の確認など、AIの自己申告以外の基準です。
- 承認する人と、その人が見る材料を決める。 承認は、方向を決める場面と、取り消しにくい操作の直前に絞ります。
- 止まったときに、誰に、いつ知らせるかを決める。 見回りと人への引き継ぎ先がないと、AIの仕事は誰にも気づかれずに止まります。
- AIに持たせない情報と権限を決める。 お金の情報、ほかのお客様の情報、自分の判断で人に連絡する権限などです。
この5つが決まっていれば、最初は調査や下書きまでを任せ、記録を見ながら少しずつ範囲を広げていけます。AI導入の考え方そのものは「AI導入に対する当社の考え方と、具体的な進め方」に、よくある失敗は「AI導入でよくある失敗と、実際にいただくご相談」にまとめています。
よくあるご質問
AIエージェントには、どこまで任せてよいですか?
結果をAIの外側で確かめられ、間違えても取り消せる仕事から任せるのが基本です。調査や下書き、テストで確かめられる作業がこれに当たります。方向を決める判断や、取り消しにくい操作の前には、人の承認を置きます。
承認が多いと、結局は人の手間が減らないのではありませんか?
承認をすべての工程に置くと、そうなります。私たちは、方向を決める場面と、取り消しにくい操作の直前の4か所に絞り、それ以外はテストの結果と見回りの仕組みで確かめています。承認する人には、判断に必要な材料だけを一か所にまとめて届けます。
AIが「完了しました」と報告したら、信じてよいですか?
信じずに、外側の結果で確かめてください。テストの結果や、反映が実際に成功したかを、AIの報告とは別に確かめる仕組みを用意しておくことをおすすめします。
小さな会社でも、AIエージェントに業務を任せられますか?
はい。一つの業務で、調査や下書きまでをAIに任せるところから始められます。当社の AI導入支援 では、最初の一つのエージェントを、貴社の業務で動かすところからお手伝いしています。
まとめ ― 任せるとは、決める人になること
AIに業務を任せるとは、AIに判断を渡すことではありません。仕事を運ぶ役割をAIに渡し、人が決める役割に集中することです。
そのためには、任せる範囲を線引きし、AIの外側の基準で結果を確かめ、承認する場所を絞り、止まったときの引き継ぎ先を決めておく必要があります。そして、うまくいかなかった場面から仕組みを直し続けることで、任せられる範囲は少しずつ広がっていきます。
私たちが Mr.AI で作った仕組みは Mr.AI の社内運用事例 に、projectAI 全体のAI活用は projectAI の全社運用事例 にまとめています。AIに任せる業務の線引きから一緒に考えたい方は、AI導入支援 からご相談ください。
参考文献
- K. J. Kevin Feng, David W. McDonald, Amy X. Zhang「Levels of Autonomy for AI Agents」2025年
- METR「Frontier Risk Report (Feb–Mar 2026)」2026年5月
- Yijia Shao ほか(スタンフォード大学)「Future of Work with AI Agents: Auditing Automation and Augmentation Potential across the U.S. Workforce」2025年(2026年改訂)
- Laksh Advani「From Confident Closing to Silent Failure: Characterizing False Success in LLM Agents」FAgen@ICML 2026
- Sunnie S. Y. Kim ほか「Fostering Appropriate Reliance on Large Language Models: The Role of Explanations, Sources, and Inconsistencies」CHI 2025
- Mert Cemri ほか(カリフォルニア大学バークレー校)「Why Do Multi-Agent LLM Systems Fail?」2025年
- MIT NANDA「The GenAI Divide: State of AI in Business 2025」2025年7月