
BLOG
ChatGPT・Claudeを仕事で使う前に確認したい利用規約の注意点
「全社にChatGPTを配ることになった。ただ、入力した内容が学習に使われるのかが分からず、情報システム部門から止められている」
「Claudeを使いたいが、法務から『規約を確認したのか』と聞かれた。どこを見ればいいのか」
「無料プランと有料プランと法人プラン、何が違うのかを説明できない」
生成AIの社内展開でご相談をいただくとき、最初につまずくのはたいていここです。技術の話ではなく、規約の理解が揃っていないところで止まります。
この記事では、ChatGPT(OpenAI)とClaude(Anthropic)を業務で使う前に確認しておきたい論点を、両社の公式規約に書かれている内容だけを根拠に整理します。
この記事の内容は2026年9月9日時点で公式ページを確認したものです。規約は改定されます。実際の判断は、そのときの最新の規約と、自社の法務部門の確認によってください。この記事は法的な助言ではありません。
1. 入力したデータは学習に使われるか
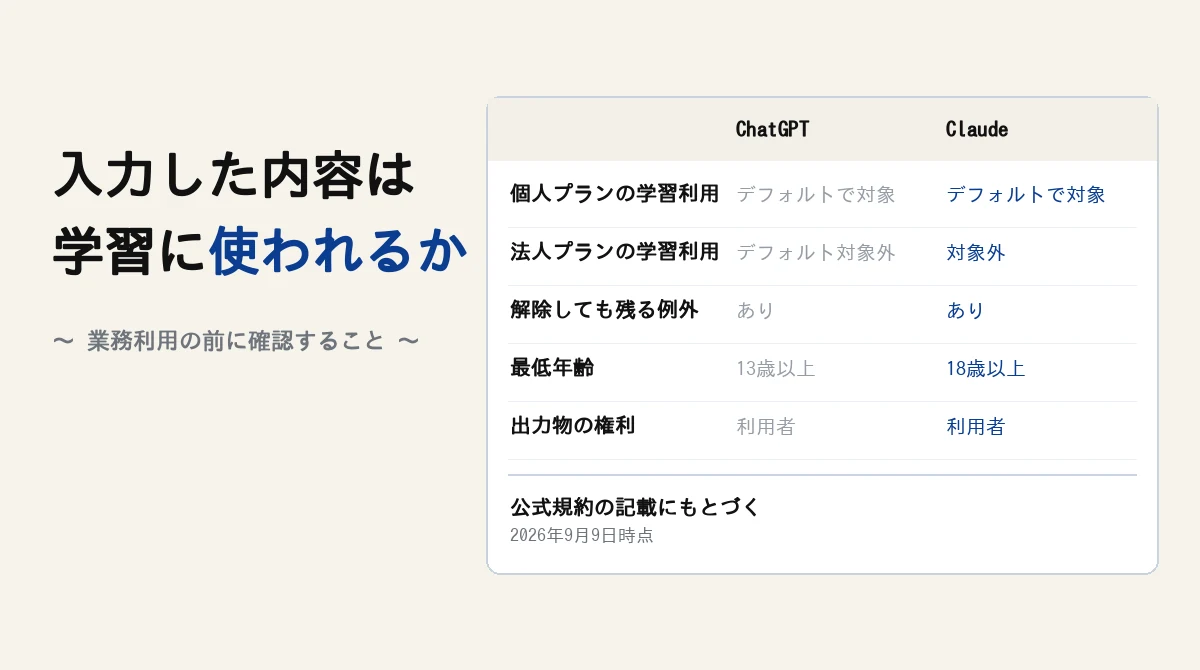
最も多い質問がこれです。プランによって扱いが違います。
個人向けプランの場合
OpenAIの利用規約には、コンテンツの利用について次のように書かれています。
We may use Content to provide, maintain, develop, and improve our Services, comply with applicable law, enforce our terms and policies, and keep our Services safe. (OpenAI Terms of use)
そのうえで、学習に使われたくない場合はオプトアウトできると明記されています。
Opt out. If you do not want us to use your Content to train our models, you can opt out by following the instructions in this article. (同上。手順はHow your data is used to improve model performance)
Anthropicの消費者向け規約にも、同じ構造の記載があります。
We may use Materials to provide, maintain, and improve the Services and to develop other products and services, including training our models, unless you opt out of training through your account settings. (Anthropic Consumer Terms of Service)
つまり個人向けプランは、どちらもデフォルトでは学習に使われうる設計で、設定でオプトアウトするという形です。
法人向けプランの場合
OpenAIは、法人向けとAPIについて明確に否定しています。
We don't train our models on your organization's data by default. By default, we do not use data from ChatGPT Enterprise, ChatGPT Business, ChatGPT Edu, ChatGPT for Healthcare, ChatGPT for Teachers, or our API platform—including inputs or outputs—for training or improving our models. (OpenAI Enterprise privacy)
Anthropicの商用規約は、さらに踏み込んだ書き方です。
Anthropic may not train models on Customer Content from Services. (Anthropic Commercial Terms of Service)
「デフォルトでは使わない」(OpenAI)と「使ってはならない」(Anthropic)で、文言の強さが異なります。社内で説明する際は、この違いを正確に伝えたほうが後の齟齬を防げます。
2. オプトアウトしても例外がある
見落とされやすい点です。Anthropicの消費者向け規約には、オプトアウトしても学習に使われる場合が明記されています。
Even if you opt out, we will use Materials for model training when: (1) you provide Feedback to us regarding any Materials, or (2) your Materials are flagged for safety review to improve our ability to detect harmful content, enforce our policies, or advance our safety research. (Anthropic Consumer Terms of Service)
つまり、回答への評価(フィードバック)を送った場合と、安全性のレビュー対象になった場合は、オプトアウトの対象外です。
社内ルールを作るときは「オプトアウトしたから何を入れても大丈夫」とは書かないほうが安全です。
3. 見落とされやすい落とし穴 ― 会社のメールで登録しても、法人契約にはならない
ここが実務で最も危険な誤解です。
会社のドメインのメールアドレスでアカウントを作っても、契約は個人のままです。個人プランに会社のメールで登録しただけの状態を、法人契約だと思い込んでいる例は珍しくありません。
紛らわしいのは、個人プランでも管理画面に組織名が表示されることです。たとえばAnthropicでは、個人プランの利用者にも「(メールアドレス)'s Organization」という組織名が自動で割り当てられ、その利用者は自身がその組織の管理者として扱われます。画面上は法人契約のように見えますが、適用される規約は消費者向けのままです。
確認すべきは画面の見た目ではなく、契約の種別です。
| 見分ける点 | 個人契約 | 法人契約 |
|---|---|---|
| 適用される規約 | 消費者向け規約 | 商用規約 |
| 学習利用 | デフォルトで対象。設定で解除 | 対象外 |
| 座席(シート)管理 | なし | あり |
| 組織名 | 自動生成(「〜's Organization」など) | 実際の組織名 |
| 支払い | 個人のクレジットカード等 | 法人契約に基づく請求 |
コーディング支援ツールも同じ扱いになる
見落とされやすいのがここです。Anthropicのプライバシーセンターは、Claude Codeの扱いをプラン種別で明確に分けています。
This article is about our consumer products such as Claude Free, Pro, Max and when accounts from those plans use Claude Code. (How long do you store my data?)
一方、商用側のヘルプはこう書いています。
This article is about certain commercial products, including the Anthropic Messages API and Claude Code on Enterprise plans. (I have a zero data retention agreement with Anthropic. What products does it apply to?)
つまり、同じツールでも個人プランで使えば消費者向け、法人プランで使えば商用扱いになります。開発支援ツールで扱う内容には自社のソースコードが含まれるため、影響はチャットの比ではありません。
学習に使われる場合、データは最長5年保持される
消費者向けプランで学習利用を許可している場合の保持期間も明記されています。
If you allow us to use your chats or coding sessions to improve Claude, we may retain your data in a de-identified format for up to 5 years in our model training pipelines. (同上)
設定を後から切っても、遡って完全には消えません。
If you decide to turn off the model improvement setting, we will not use your previous or new chats or coding sessions for future model training. ... Your data will still be included in model training runs that are already in progress, or in models that have been trained. (同上)
「気づいた時点で設定を切れば元に戻る」わけではないという点は、社内で共有しておく価値があります。
業務で使うなら、個人アカウントは禁止すべきです
ここまでの事実から、WTは次の方針をおすすめしています。
業務データを扱う生成AIの利用は、法人契約のアカウントに限定し、個人アカウントでの業務利用は明示的に禁止する。
理由は4つあります。
- 適用される規約が違う。個人契約は消費者向け規約の下にあり、学習利用はデフォルトで対象です。設定に依存する運用は、担当者が変わった時点で崩れます。
- 会社から見えない。個人アカウントは管理者から利用状況を把握できません。誰が何を入力したかを確認する手段がなく、退職時にアカウントを回収することもできません。
- 設定は個人任せになる。オプトアウトしているかどうかを、会社が確認する方法がありません。本人が善意で使っていても、設定ひとつで扱いが変わります。
- 遡って取り消せない。学習に使われた分は、設定を切っても既に進行中の学習からは除外されません。
禁止するだけでは現場が困るため、同時に法人契約の受け皿を用意することが前提です。使える環境がないまま禁止すると、かえって管理外の利用が増えます。
4. 学習に使われる場合、AI会社の中では何が起きているか
「学習に使われる」と聞くと、入力した文章がそのまま保存され、社員に読まれ、他の利用者への回答にそのまま出てくる、という想像をされることが多いです。まず、特定のサービスに限らない一般的な仕組みを押さえ、そのうえで両社が公式に書いていることを見ていきます。
まず、一般的な処理の流れを押さえる
ここはChatGPTやClaudeに限らない、クラウド型のAIをAPI経由で使うときの一般的な仕組みです。事業者ごとの実装や契約条件で細部は変わりますが、骨格はほぼ共通しています。例として、社内の資料をAPIに送って校正や要約をしてもらう場合を考えます。
| 段階 | 何が行われるか | データがどこにあるか |
|---|---|---|
| 1. リクエスト送信(自社 → AI事業者) | 資料のテキストと指示文(プロンプト)をひとつのリクエストにまとめ、通信を暗号化(TLS)して事業者のAPIに送る | 自社システムのメモリ上。自社側でログを残す設定にしていれば、自社のサーバーやデータベース |
| 2. 認証と前処理(APIゲートウェイ) | APIキーやトークンで正規の利用者かを確認し、利用量の上限を確認する。有害な内容を機械的に判定するフィルターにかける | 事業者のゲートウェイのメモリ上(一時的) |
| 3. 推論(AIモデル環境) | 資料と指示文をモデルが扱う単位(トークン)に変換し、GPUなどの計算機上で校正・要約・書き換えの処理を行う | 推論サーバーのメモリ上。処理が終わればメモリから解放される |
| 4. レスポンス返送(AI事業者 → 自社) | 生成されたテキストが暗号化された通信で自社のアプリに戻り、資料が更新される | 自社のアプリケーションやストレージ |
| 5. 監視ログの保管と自動消去(事業者のストレージ) | 規約違反の検知や障害解析のために入出力を一定期間保管し、期限が来たら消去する | 事業者側の分離・暗号化されたストレージ(オブジェクトストレージと鍵管理サービスの組み合わせが一般的) |
このフローで押さえておきたいのは3点です。
- モデルはリクエストの処理中に学習していない。3の推論は「計算」であり、モデルの中身(パラメータ)はこの処理で変わりません。学習は、5で保管されたデータや別途集めたデータを後日まとめて学習用データセットに取り込み、モデルを作り直す別の工程(バッチ処理)です。つまり「入力が学習に使われるか」は、このフローそのものではなく、5で保管されたデータが学習工程に渡されるかどうかで決まります。それを決めているのが契約と設定です。1章で見た「法人向けは学習に使わない」は、この受け渡しをしないという約束です。
- 事業者側にデータが残るのは5だけ。1から4のデータは処理が終われば消えます。事業者側に一定期間残るのは、監視ログとして保管される5の分です。この保管期間と、その間に誰がアクセスできるかが、この章の後半で扱う各社の公式記載です。
- 自社側の保存は自社の責任。1と4で自社のログやストレージに残る分は、AI事業者の規約とは無関係に自社の管理対象です。「AI事業者が30日で消す」ことと「自社のログに残り続ける」ことは別の話です。
以上は一般的な仕組みの説明で、各社が実際にどう実装しているかは公式ページで確認する必要があります。ここから先は、5で保管されたデータが学習工程に渡される場合に、両社が何をすると公式に書いているかを見ていきます。
学習に回す前に、アカウントとの紐づけを外す
Anthropicは、学習に使う前にユーザーIDとの紐づけを外し、機微な情報をフィルタする処理を説明しています。
Where you have allowed us to use your chats and coding sessions to improve Claude, we will automatically de-link them from your user ID (e.g. email address) before it's used by Anthropic. (How Do You Use Personal Data in Model Training?)
We will use tools and processes derived from our work on privacy-preserving analysis tools to filter or obfuscate sensitive data. (同上)
OpenAIも、学習用データに含まれる個人情報を減らす処理を行うと書いています。
We retain certain data from your interactions with us, but we take steps to reduce the amount of personal information in our training datasets before they are used to improve and train our models. (How your data is used to improve model performance)
Our models are built to learn about the world, not about private individuals. We don't seek out personal information, we don't build profiles from public data, and we work to identify and remove personal identifiers from training sets wherever possible. (OpenAI Consumer privacy)
両社とも「誰の入力か」を切り離し、個人を特定する情報を減らしたうえで学習に使う、という説明です。ただし、ここで書かれているのは個人情報についての処理です。未公開の事業計画、顧客リスト、ソースコードのような営業秘密を取り除くという記載は、確認した範囲では見当たりませんでした。
学習に入るのは会話の全体。連携先の元データは含まれない
Anthropicは、学習に使う範囲を具体的に書いています。
Chat and coding session data we may use for improving our models includes the entire related conversation, along with any content, custom styles or conversation preferences, as well as data collected when using Claude for Chrome. It does not include raw content from connectors (e.g. Google Drive), including remote and local MCP servers, though data may be included if it's directly copied into your conversation with Claude. (Is my data used for model training?)
つまり、Google Driveなどを連携しただけでは元ファイルは学習に入りませんが、会話に貼り付けた時点で対象になります。社内ルールで「連携は可、貼り付けは不可」のような線引きをする場合の根拠になります。
モデルはデータベースのように文章を保存しない
Anthropicは、学習後のモデルが元データをどう扱うかを次のように説明しています。
Models do not store text like a database, nor do they simply "mash-up" or "collage" existing content. Models identify general patterns in text in order to help people create new content, and they do not have access to or pull from the original training data once the models have been trained. (How Do You Use Personal Data in Model Training?)
OpenAIは、学習の段階と使うデータの出どころを書いています。
OpenAI trains its models in two stages. First, we learn from a large amount of data. Then, we use data from ChatGPT users and human trainers to make sure the outputs are safe and accurate and to improve their general capabilities. (OpenAI Enterprise privacy)
OpenAI uses data from different places including public sources, licensed third-party data, and information created by human reviewers. We also use data from versions of ChatGPT and other services for individuals. (同上)
学習後のモデルは元の文章を参照して答えているわけではない、というのが両社の説明です。一方で、これは後から特定のデータだけを取り出して消すことができないことも意味します。この点は次の「訂正・削除を依頼した場合」で扱います。
用途は限定されている
Anthropicは、学習データに含まれた個人情報の用途を限定しています。
We do not use such personal data to contact people, build profiles about them, to try to sell or market anything to them, or to sell the information itself to any third party. (How Do You Use Personal Data in Model Training?)
例外扱いのデータは別ルートで扱われる
2章で触れたオプトアウトの例外(フィードバックと安全性レビュー)は、通常の学習データとは別の扱いになります。
フィードバックは、紐づけを外したうえで会話全体が保管され、他の会話とは結合されません。
When you provide us feedback via our thumbs up/down button, we will store the entire related conversation, including any content, custom styles or conversation preferences, in our secured back-end for up to 5 years. ... We de-link your feedback from your user ID (e.g. email address) before it's used by Anthropic. ... We do not combine your feedback with your other conversations with Claude. (Is my data used for model training?)
OpenAIも、フィードバックを送ると会話全体が学習対象になると書いています。
If you choose to provide feedback, the entire conversation associated with that feedback may be used to train our models. (How your data is used to improve model performance)
安全性レビューの対象になった会話は、保持期間が長くなります。
We retain inputs and outputs for up to 2 years and trust and safety classification scores for up to 7 years if your chat or session is flagged by our automated trust and safety systems as violating our Usage Policy. (How long do you store my data?)
さらにAnthropicのプライバシーポリシーは、規約違反への対処のために紐づけを戻す場合があると明記しています。
If our systems flag Inputs or Outputs for harmful content or for potentially violating our policies, we disassociate the content from your user ID to train our trust and safety internal classification and generative models. However, we may re-identify the Inputs or Outputs to enforce our Terms of Service or Usage Policy with the responsible user if necessary. (Anthropic Privacy Policy)
学習に使われない法人契約でも、一定期間は保管される
法人契約やAPIでは学習には使われませんが、不正利用の監視のために一定期間は保管されます。誰がその期間にアクセスできるかも公式ページに書かれています。
OpenAI may securely retain API inputs and outputs for up to 30 days to provide the services and to identify abuse. After 30 days, API inputs and outputs are removed from our systems, unless we are legally required to retain them. (OpenAI Enterprise privacy)
Our access to API business data stored on our systems is limited to (1) authorized employees that require access for engineering support, investigating potential platform abuse, and legal compliance and (2) specialized third-party contractors who are bound by confidentiality and security obligations, solely to review for abuse and misuse. (同上)
For Anthropic API users, we automatically delete inputs and outputs on our backend within 30 days of receipt or generation, except:
- When you use a service with longer retention under your control (e.g. Files API)
- When you and we have agreed otherwise (e.g. zero data retention agreement)
- If we need to retain them for longer to enforce our Usage Policy (UP)
- In compliance with the law (How long do you store my organization's data?)
Anthropicは、特定の高性能モデル(Covered Models)について、保管中のデータに社員がどうアクセスするかも公開しています。
By default, no Anthropic personnel can read your retained conversations. Human review can occur only through a controlled access path—for example, when content is flagged by our automated trust and safety systems for potential harm. These reviews can only be performed by a small set of approved reviewers. Every instance of access is recorded in a tamper-proof log that reviewers cannot suppress or modify. (Data retention practices for Covered Models)
社内で「学習に使われるとはどういうことか」を説明するときは、次の4点にまとめると伝わりやすくなります。
- リクエストの処理中にモデルが学習することはない。学習は保管データを使った別工程で、渡すかどうかは契約と設定で決まる
- 学習に回す前に、誰の入力かの紐づけを外し、個人情報を減らす処理が行われる
- 学習後のモデルは元の文章を保存しておらず、参照もしない
- だからこそ、学習済みモデルから特定のデータだけを後から取り除くことはできない
5. 出力物の権利は誰のものか
両社とも、出力物の権利は利用者に帰属すると明記しています。
As between you and OpenAI, and to the extent permitted by applicable law, you (a) retain your ownership rights in Input and (b) own the Output. We hereby assign to you all our right, title, and interest, if any, in and to Output. (OpenAI Terms of use)
Anthropic agrees that Customer (a) retains all rights to its Inputs, and (b) owns its Outputs. (Anthropic Commercial Terms of Service)
ただしOpenAIは、出力が一意とは限らないことも同じ規約に書いています。
Due to the nature of our Services and artificial intelligence generally, output may not be unique and other users may receive similar output from our Services. (OpenAI Terms of use)
他の利用者が似た出力を受け取る可能性があるという前提は、生成物をそのまま自社の独自コンテンツとして扱う場面で効いてきます。
6. 年齢とアカウントの要件が違う
ここは両社ではっきり差があります。
| 最低年齢 | |
|---|---|
| OpenAI | 13歳以上、または居住国で同意可能な最低年齢。18歳未満は保護者の許可が必要 |
| Anthropic | 18歳以上、または居住地で同意可能な最低年齢のうち高いほう |
Minimum age. You must be at least 13 years old or the minimum age required in your country to consent to use the Services. If you are under 18 you must have your parent or legal guardian's permission to use the Services. (OpenAI Terms of use)
You must be at least 18 years old or the minimum age required to consent to use the Services in your location, whichever is higher. (Anthropic Consumer Terms of Service)
インターンや学生アルバイトを含む職場では、確認しておく価値があります。
7. 禁止されている使い方
両社とも利用ポリシーで禁止事項を定めています。業務で触れる可能性のあるものを挙げます。
OpenAIの利用ポリシー(Usage policies)から、業務に関係しやすい項目です。
- 他者のシステムや財産の破壊・侵害、知的財産権の侵害の試み
- 本人の許可なく個人の私的・機微な情報を集約、監視、プロファイリング、配布すること
- 資格が必要な助言(法務や医療など)を、有資格者の適切な関与なしに提供すること
- データ主体の同意がない顔認識データベースの作成
Anthropicの利用ポリシー(Usage Policy)は、次のような柱で構成されています。
- 法令違反や違法行為をしない
- 重要インフラを侵害しない
- コンピューターやネットワークを侵害しない
- プライバシーや同一性の権利を侵害しない
- 誤情報を作成・拡散しない
- 詐欺的、濫用的、略奪的な行為をしない
加えてAnthropicの消費者向け規約は、競合サービスの開発目的での利用を禁止しています。
To develop any products or services that compete with our Services, including to develop or train any artificial intelligence or machine learning algorithms or models or resell the Services. (Anthropic Consumer Terms of Service)
自社でAIを使ったサービスを作ろうとしている場合は、この条項の解釈を法務に確認しておいてください。
8. データはいつ消えるか
Anthropicのプライバシーポリシーには、削除した会話の扱いが書かれています。
...which will be removed immediately from your conversation history and automatically deleted from our back-end within 30 days. (Anthropic Privacy Policy)
ただし同ポリシーには、法的・契約上の義務などにより削除の求めに関わらず保持する場合があることも書かれています。「削除すれば必ず消える」とは限らないという前提で運用してください。
OpenAIについては、一時チャット(temporary chat)を使った場合の扱いが公開されています。
With temporary chats, your conversations are automatically deleted, don't inform your ChatGPT memory, and aren't used to train our models. (OpenAI Consumer privacy)
9. AI会社にデータやコードの訂正・削除を依頼した場合はどうなるか
「顧客情報を誤って貼り付けてしまった」「個人アカウントのコーディング支援ツールに社内のソースコードを読み込ませていた」「ChatGPTが自社の役員について誤った経歴を答える」。こうしたとき、AI会社に依頼して何が戻せるのか。公式ページに書かれている範囲で、ケース別に整理します。
ケース1: 会話やコーディングセッションを自分で削除する
両社とも、削除した会話は30日以内にシステムから消えると書いています。ただし、どちらにも例外があります。
When you delete a chat (or your account), the chat is removed from your account immediately and scheduled for permanent deletion from OpenAI systems within 30 days, unless: The chat has already been de-identified and disassociated from you, or OpenAI must retain it longer for security or legal obligations. (Chat and File Retention Policies in ChatGPT)
If you decide to turn off the model improvement setting, we will not use your previous or new chats or coding sessions for future model training. Additionally, if you delete a chat from your chat history, it will not be used to train future models. Your data will still be included in model training runs that are already in progress, or in models that have been trained. (How long do you store my data?)
削除で消えるのは保管されている会話です。学習用に紐づけを外して切り離された分(OpenAI)や、すでに進行中・完了した学習(Anthropic)は、削除の対象に含まれません。
ケース2: すでに学習に使われた分を取り消したい
学習済みモデルから特定のデータを取り除く手続きは、確認した範囲では両社の公式ページに用意されていません。Anthropicは、学習データに関する権利行使には限りがあると明記しています。
This includes your right to request a copy of your personal data, and to object to our processing of your personal data or request that it is deleted. We make every effort to respond to such requests. However, please be aware that these rights are limited, and that the process by which we may need to action your requests regarding our training dataset are complex. (How Do You Use Personal Data in Model Training?)
OpenAIのプライバシーポリシーも、削除依頼の対象から学習用に切り離した分を除いています。
Once you choose to delete Personal Data, we will remove it from our systems within 30 days unless we need to retain it for longer as described below, or it has already been de-identified and disassociated from your account when you allow us to use your Content to improve our models. (OpenAI Privacy policy)
依頼で止められるのはこれからの学習利用です。4章で見たとおり、学習後のモデルは元の文章を保存していないため、「この会話の分だけ取り除く」という操作自体が想定されていません。
ケース3: 自分や自社の人物について誤った出力が出る
出力に含まれる誤った個人情報については、両社とも訂正・削除の依頼窓口を用意しています。ただし、対応は「できる範囲で」という書き方です。
If you notice that ChatGPT output contains factually inaccurate information about you and you would like to request a correction or removal of the information, you can submit these requests through privacy.openai.com or to dsar@openai.com, and we will consider your request based on applicable law and the technical capabilities of our models. (OpenAI Privacy policy)
Please note that we cannot guarantee the factual accuracy of Outputs. If Outputs contain factually inaccurate personal data relating to you, you can submit a correction request and we will make a reasonable effort to correct this information—but due to the technical complexity of our large language models, it may not always be possible for us to do so. (Anthropic Privacy Policy。窓口は privacy@anthropic.com)
依頼には本人確認が伴います。OpenAIは、確認できない場合は対応できないと書いています。
In order to protect your Personal Data from unauthorized access, change, or deletion, we may require you to verify your credentials before you can submit a request to know, correct, or delete Personal Data. ... If we cannot verify your identity, we will not be able to honor your request. (OpenAI Privacy policy)
回答期限は、適用される法律によります。AnthropicはEU・UKのGDPRが適用される場合は1か月以内に回答すると書いています。日本の利用者にどの期間が適用されるかは、依頼時に確認してください。
ケース4: 法人契約で、社員が入力したデータの削除を依頼する
法人契約では、社員が個人としてAI会社に依頼する形にはなりません。窓口は自社の管理者です。Anthropicは、法人契約ではデータの管理者が顧客企業側であることを明記しています。
Please note, the Privacy Policy does not apply where Anthropic acts as a data processor and processes personal data on behalf of commercial customers using Anthropic's Commercial Services. In those cases, the commercial customer is the controller, and you can review their policies for more information about how they handle your personal data. (How Do You Use Personal Data in Model Training?)
アカウントや組織の削除も、管理者経由です。
If you are a Claude for Work, Claude for Enterprise or Console user, you will need to contact your accounts primary owner, owner, or account manager to have your account deleted. ... Note that organization level account deletion requests must be made by your accounts Primary Owner. (Deleting commercial Anthropic accounts)
Enterprise plan customers can also set custom retention timelines for their organization's data. (Can you delete data that I sent via Team and Enterprise plans?)
OpenAIの法人プランも同じ構造で、管理者が社員の会話を削除でき、削除後は30日以内に消えます。
Workspace admins have control over workspaces and can view, access, export, and delete end user conversations in the workspace. (OpenAI Enterprise privacy)
Your workspace admins control how long your data is retained. Any deleted conversations are removed from our systems within 30 days, unless we are legally required to retain them. (同上)
つまり法人契約では、「誰が管理者か」「社員が誤入力に気づいたとき誰に報告するか」を社内で決めておかないと、削除の依頼自体が動きません。
ケース5: ソースコードの場合
コードもチャットと同じ扱いです。Anthropicの各ページは一貫して「chats or coding sessions」と併記しており、削除の期限も、学習済みモデルから戻せない点も、チャットと変わりません。
OpenAIのCodexには、チャットの設定とは別の学習設定があります。
If you use Codex on a personal ChatGPT plan, the "Improve the model for everyone" setting also applies to your Codex tasks. ... Codex has a separate setting for training on full environments in Codex Settings. Changing the ChatGPT setting or opting out through the privacy portal does not change that Codex setting. (Data Controls FAQ)
チャットの学習設定を切っても、Codexの環境(リポジトリ全体)の学習設定は別です。個人アカウントで開発支援ツールを使う場合、確認する設定が2か所あることになります。
依頼で戻せる範囲
| 依頼の内容 | 戻せる範囲 |
|---|---|
| 保管中の会話・コードの削除 | 30日以内に削除される。法的義務や安全性の理由で残る例外あり |
| これからの学習利用の停止 | 設定またはオプトアウトで可能 |
| 学習済みモデルからの除去 | 手続きなし。進行中・完了した学習からは除外されない |
| 出力に含まれる誤った個人情報の訂正 | 依頼できるが、対応は「可能な範囲」。本人確認が必要 |
| 法人契約での社員データの削除 | 自社の管理者が窓口。管理者が削除すれば30日以内に消える |
実務上の結論は、依頼で戻せるのは保管中のデータまで、ということです。学習に回った分は依頼しても戻りません。だからこそ、次の章で扱う「何を入力してよいか」を、入力する前に決めておく必要があります。
10. 社内ルールで決めておくこと
ここまでの内容を踏まえ、規約を読むだけでは決まらない部分を挙げます。ここは各社が自分で決める必要があります。
- どのプランを使うか。学習利用の扱いがプランで変わる以上、これが最初の判断です。業務データを扱うなら法人向けを選ぶ、という方針を明文化しておきます。
- 何を入力してよいか。顧客の個人情報、未公開の財務情報、他社との秘密保持契約の対象。入力してよいものと、してはいけないものの線引きを、具体例で示してください。「機密情報は入力しない」だけでは現場で判断できません。
- 出力物をどう扱うか。他の利用者が似た出力を受け取りうる前提で、そのまま外部に出してよいのか、確認の工程を挟むのかを決めます。
- 誰が承認するか。新しいAIサービスを使い始めるときの申請先と、判断する人を決めておきます。
- 誤って入力したときにどうするか。9章で見たとおり、依頼で戻せるのは保管中のデータまでです。気づいた本人が会話を削除する、管理者に報告する、必要ならAI会社の窓口に依頼する、という順番と担当を決めておきます。法人契約では管理者が削除の窓口になるため、誰が管理者かを全員が知っている状態にしてください。
- いつ見直すか。規約は改定されます。半年に一度など、定期的に確認する担当と時期を決めておいてください。
WTでは、こうした社内ルールの整備を含めてAI導入支援を行っています。データを社外に出さない構成の設計も含め、ご相談いただけます。
よくあるご質問
無料プランと有料プランで、学習利用の扱いは変わりますか?
公式規約に書かれているのは、個人向けか法人向けかによる違いです。OpenAIは法人向けとAPIについてデフォルトでは学習に使わないと明記し、Anthropicは商用規約で顧客コンテンツを学習に使ってはならないとしています。個人向けプランは、どちらも設定でオプトアウトする形です。無料と有料の別で扱いが変わるという記載は、確認した範囲では見当たりませんでした。
オプトアウトすれば、機密情報を入力しても問題ありませんか?
規約上、オプトアウトには例外があります。Anthropicの消費者向け規約は、フィードバックを送った場合と安全性レビューの対象になった場合は学習に使うと明記しています。オプトアウトを機密情報入力の根拠にはしないでください。
出力物を自社の製品に使えますか?
両社とも、出力物の権利は利用者に帰属すると規約に明記しています。ただしOpenAIは出力が一意とは限らないと注記しており、Anthropicの消費者向け規約には競合サービスの開発目的での利用禁止があります。用途によって判断が変わるため、具体的な利用方法を法務に確認してください。
社内で何歳から使わせてよいですか?
OpenAIは13歳以上(18歳未満は保護者の許可が必要)、Anthropicは18歳以上と定めています。基準が異なるため、使うサービスごとに確認が必要です。
会社のメールアドレスで登録すれば、法人契約になりますか?
なりません。会社のドメインのメールアドレスを使っても、個人プランに登録した時点で契約は個人のままです。個人プランでも管理画面に自動生成の組織名が表示されるため法人契約に見えますが、適用されるのは消費者向け規約です。契約種別は、座席管理の有無や請求の形で確認してください。
社員が個人アカウントで業務に使うのは問題ですか?
推奨できません。適用される規約が消費者向けになり学習利用がデフォルトで対象になること、会社から利用状況を把握できないこと、設定が個人任せになること、学習に使われた分を遡って取り消せないことが理由です。禁止する場合は、同時に法人契約の受け皿を用意してください。使える環境がないまま禁止すると、管理外の利用が増えます。
AIに資料を送ると、その場でAIがその資料を覚えてしまうのですか?
一般的なクラウド型AIの仕組みでは、リクエストの処理(推論)はモデルの中身を変えない計算で、処理が終わればメモリから消えます。学習は、事業者側に保管されたデータを後日まとめて使う別の工程です。したがって「覚えるかどうか」は、保管されたデータが学習工程に渡されるかどうか、つまり契約と設定で決まります。
学習に使われると、入力した文章がそのまま他の人の回答に出てきますか?
両社の公式ページは、学習に回す前にユーザーとの紐づけを外し個人情報を減らす処理を行うこと、学習後のモデルはデータベースのように文章を保存するものではないことを説明しています。一方で、学習済みモデルから特定のデータだけを取り除く手続きはありません。「そのまま出てくる」とも「絶対に出てこない」とも公式には書かれていないため、営業秘密を入力しない運用のほうが確実です。
誤って機密情報を入力してしまいました。AI会社に依頼すれば消せますか?
保管中の会話は、自分で削除すれば30日以内に消えると両社が書いています。ただし、すでに学習用に切り離された分や進行中・完了した学習からは除外されません。出力に含まれる誤った個人情報の訂正も依頼できますが、対応は「可能な範囲」です。法人契約の場合は自社の管理者が削除の窓口になります。
コーディング支援ツールも同じ扱いですか?
プラン種別によります。Anthropicのプライバシーセンターは、個人向けプラン(Free、Pro、Max)のアカウントがClaude Codeを使う場合を消費者向け製品として扱い、Enterpriseプランでの利用を商用製品として扱うと明記しています。開発支援ツールで扱う内容には自社のソースコードが含まれるため、影響はチャットより大きくなります。削除や学習済みモデルからの除去についてはチャットと同じ扱いで、OpenAIのCodexにはチャットとは別の環境学習設定があります。
規約が変わったらどう気づけばよいですか?
両社とも規約の更新を告知しています。定期的に確認する担当と時期を社内ルールに含めておくのが現実的です。この記事の内容も2026年9月9日時点のものです。
まとめ
生成AIの業務利用でつまずくのは、技術ではなく前提の共有です。確認すべき点は次の8つに集約されます。
- 使うプランで学習利用の扱いが変わる
- オプトアウトには例外がある
- 会社のメールで登録しても、個人プランなら契約は個人のまま
- 学習に回す前に紐づけを外す処理はあるが、学習済みモデルからは取り出せない
- 出力物の権利は利用者に帰属するが、一意とは限らない
- 年齢要件がサービスごとに違う
- 禁止用途は公式ポリシーに列挙されている
- 訂正・削除を依頼して戻せるのは、保管中のデータまで
なかでも3つ目は、気づかないまま運用が続きやすい点です。業務データを扱うのであれば、法人契約のアカウントに限定し、個人アカウントでの業務利用は明示的に禁止することをおすすめします。あわせて、使える環境を用意することが前提です。
そのうえで、何を入力してよいか、誰が承認するか、いつ見直すかは、各社が自分で決めるしかありません。
社内ルールの整備からご相談されたい場合は、お問い合わせからお知らせください。
免責: この記事は2026年9月9日時点で公開されている公式規約を確認して作成したもので、法的な助言ではありません。実際の判断は最新の規約と自社の法務確認によってください。